AI 코딩 에이전트 검증 루프: 테스트 통과와 완료의 차이
AI 코딩 에이전트 검증 루프는 코드 변경 뒤 테스트와 실제 결과 상태를 확인하고, 실패 원인을 다음 수정에 돌려주는 절차입니다. 테스트가 모두 통과해도 검사에 빠진 요구사항까지 충족했다는 뜻은 아닙니다. 2026년 9월 17일 기준 Anthropic의 에이전트 평가·장기 실행 하네스 문서와 Node.js 공식 문서를 바탕으로, 완료 판정의 범위와 짧은 재현 실험을 설명합니다.
- 응답·실행·결과 상태를 구분하는 기준
- 실패를 수정으로 연결하는 검증 루프의 구성
- 테스트 범위를 넓혔을 때 달라지는 실제 실행 결과
- 코드 검사·모델 평가·사람 검토의 역할 분담
- 테스트 변경과 환경 차이를 다루는 운영 체크리스트
주요 원문: Demystifying evals for AI agents · Effective harnesses for long-running agents.
1. AI 코딩 에이전트 검증 루프는 무엇을 확인하나?
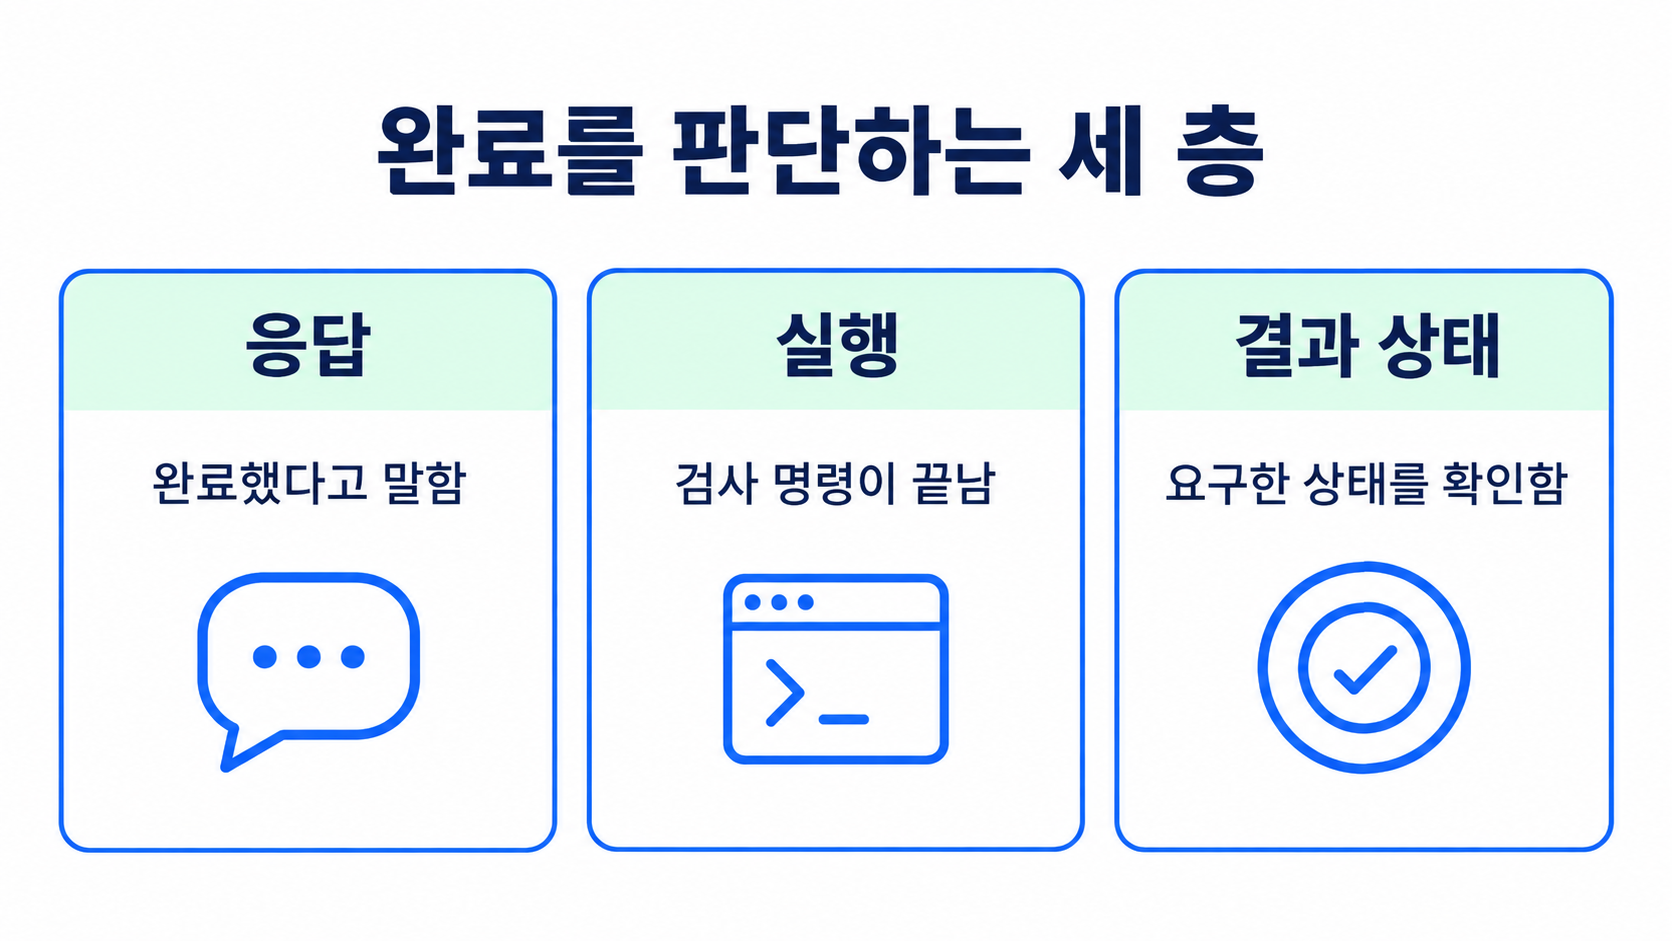
에이전트의 응답과 환경의 결과는 다릅니다
Anthropic의 평가 문서는 작업 기록인 transcript와 최종 환경 상태인 outcome을 구분합니다. 수정 완료 메시지는 설명이고, 변경 파일·검사 결과·사용자가 보게 될 동작은 별도 증거입니다.
검증 루프와 평가 하네스의 역할
평가 하네스는 여러 작업의 실행·기록·채점을 담당하는 기반 시스템으로, 모델과 도구·실행 제어의 조합을 평가합니다.
2. “잘 확인해 줘”라는 지시만으로 부족한 이유
한 번에 큰 작업을 맡기면 완료 기준이 흐려집니다
Anthropic의 장기 실행 하네스 실험에서는 에이전트가 많은 기능을 한꺼번에 구현하려다 중간 상태를 남기거나, 일부 기능이 생긴 뒤 전체 작업이 끝났다고 판단하는 문제가 관찰됐습니다. 연구진은 초기 기능 목록과 진행 기록을 만들고 이후 세션이 한 기능씩 처리하도록 구성했습니다. 특정 실험의 설계이므로 효과를 일반화할 수는 없습니다.
검사를 실행했다는 기록에도 범위가 필요합니다
test 명령의 종료 코드만 저장하면 어떤 파일과 조건을 검사했는지 놓칠 수 있습니다. 이 글의 운영 제안은 검사 명령, 대상 코드 버전, 선택한 테스트, 통과·실패·건너뜀 수를 함께 남기는 것입니다. 응답을 JSON으로 받아 자동 수집하려면 Claude Code JSON 출력 방법: 스키마 검증·자동화 가이드를 참고할 수 있지만, 구조화된 보고 형식 자체가 결과의 참을 보장하지는 않습니다.
3. 검증 루프는 어떤 순서로 작동해야 하나?
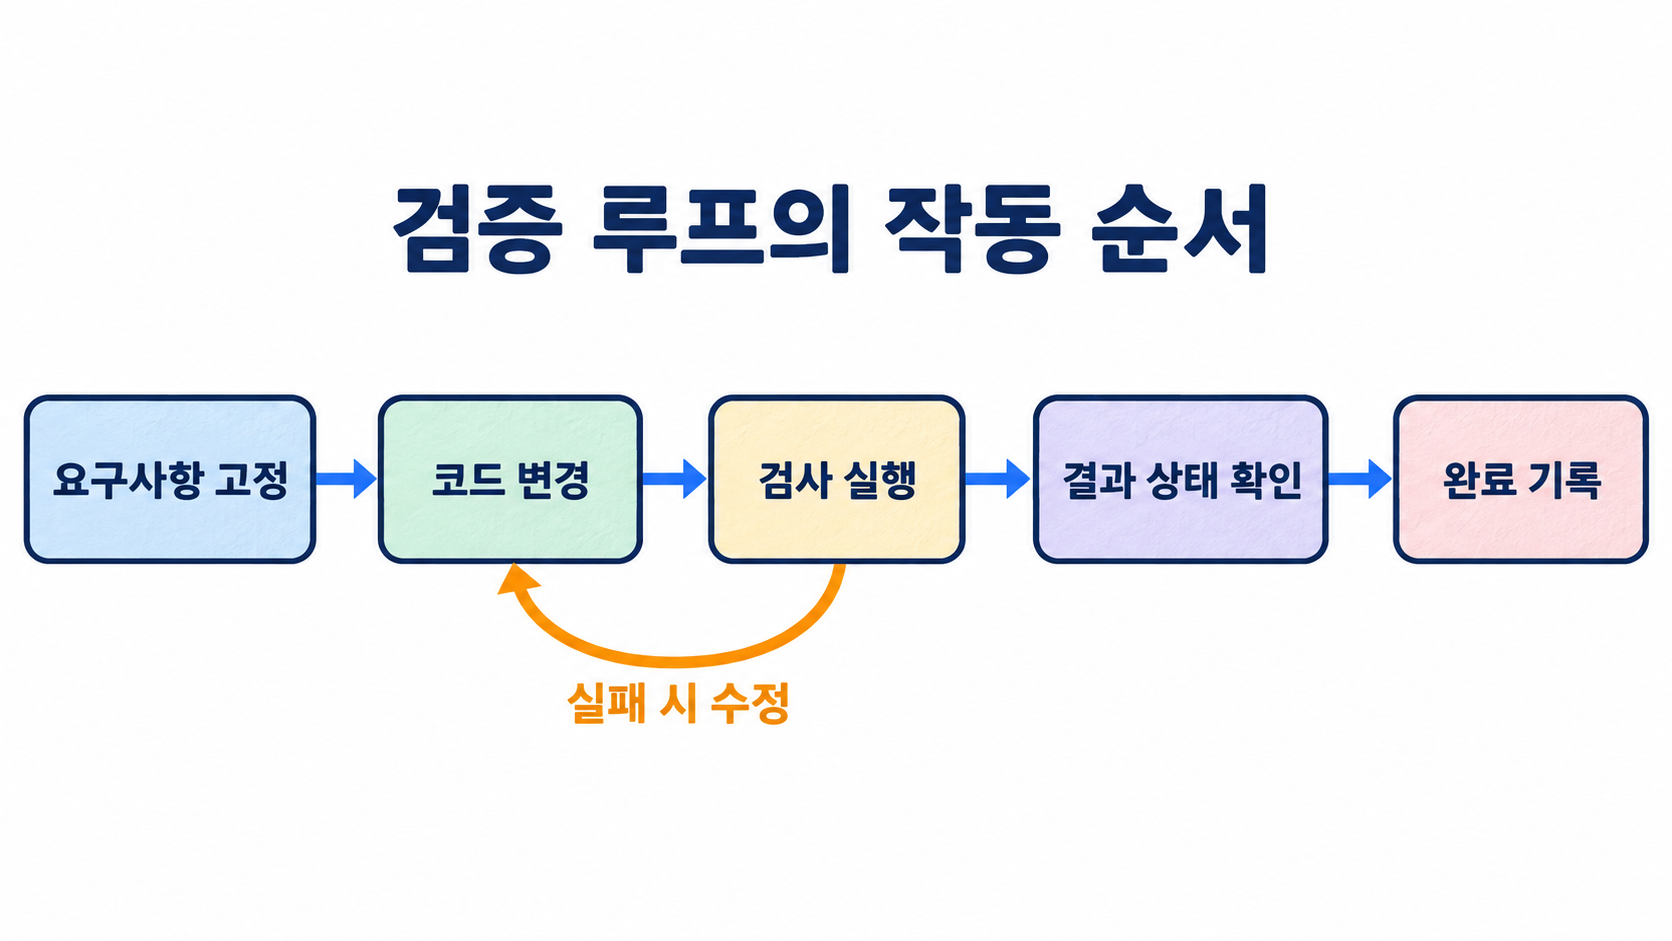
요구사항을 먼저 검사 가능한 조건으로 바꿉니다
“장바구니 합계를 구현한다”보다 “숫자 가격 목록의 합을 구하며 빈 목록의 합은 0이다”가 검사 작성에 적합합니다. 정상 입력, 경계 입력, 실패 조건을 정의한 뒤 테스트로 연결합니다. 예상값을 구현에서 베끼지 말고 요구사항에서 정해야 같은 오류의 재현을 피할 수 있습니다.
실패 정보와 종료 조건을 함께 둡니다
검사 실패 시에는 실패한 조건과 관련 로그를 다음 수정에 전달합니다. 검사 통과 뒤에는 필요한 경우 실제 화면·저장 상태를 확인하고, 그 증거와 함께 완료를 기록합니다. 환경 문제를 코드 결함으로 오인한 불필요한 수정은 피해야 합니다.
운영 제안: 최대 재시도 횟수·시간·비용을 별도로 정하고 같은 실패가 반복되면 검토 대상으로 전환합니다. 무한 반복을 막는 예산 제어는 Claude Code 비용 제한 설정: 예산·턴·시간 제어법에서 다룹니다.
4. 실제 실험: 테스트 하나가 통과한 코드의 빈틈
아래는 이 글을 위해 작성하고 Node.js v24.19.0에서 실제 실행한 교육용 예제입니다. Claude·Codex에 동일 과제를 반복 의뢰한 벤치마크가 아니며, 특정 모델의 실패율이나 수정 능력을 측정하지 않았습니다.
정상 입력만 검사하면 첫 구현은 통과합니다
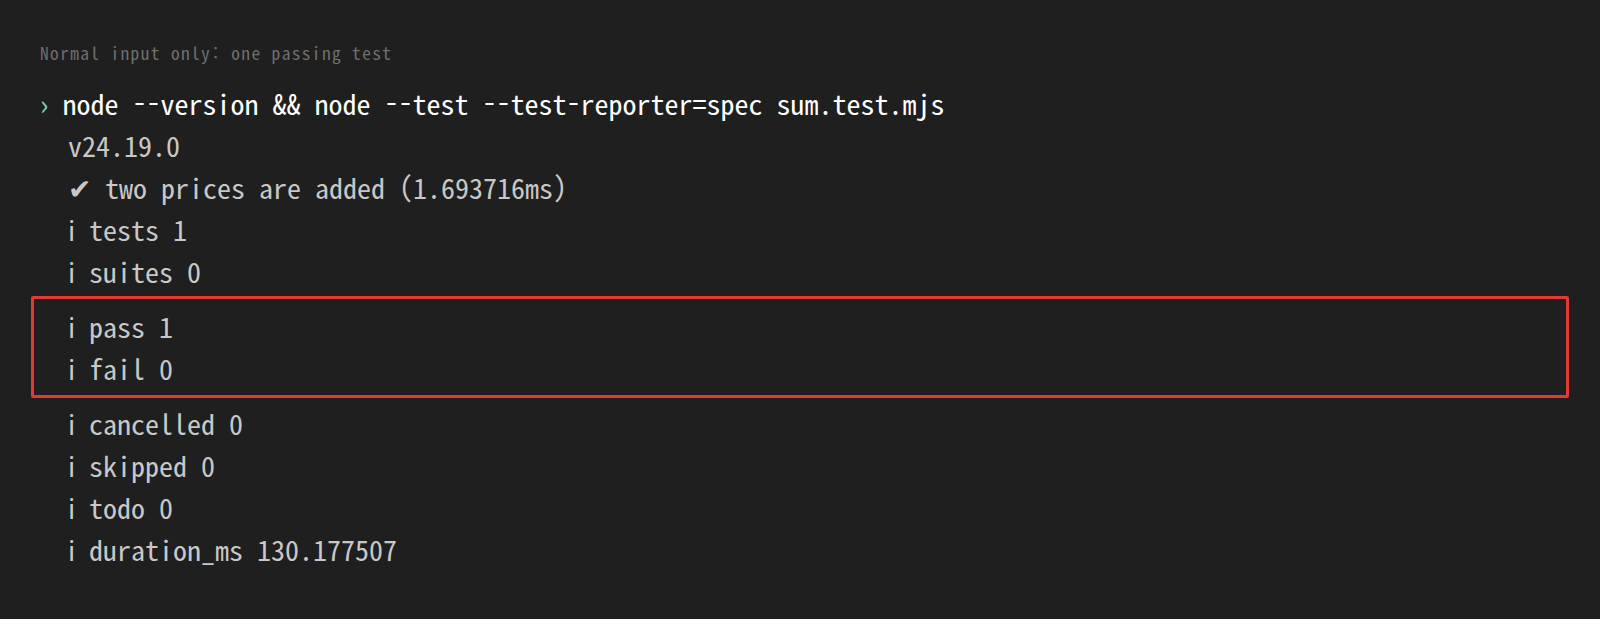
첫 구현은 reduce에 초기값을 주지 않았습니다. [10, 20]을 넣어 30이 나오는지만 확인한 테스트는 실제로 통과했습니다. 아래 코드는 파일 두 개로 나누어 저장합니다.
// sum.mjs — 첫 구현
export function sumPrices(prices) {
  return prices.reduce((total, price) => total + price);
}

// sum.test.mjs
import test from 'node:test';
import assert from 'node:assert/strict';
import { sumPrices } from './sum.mjs';

test('two prices are added', () => {
  assert.equal(sumPrices([10, 20]), 30);
});
node --test --test-reporter=spec sum.test.mjs빈 입력을 추가하면 같은 구현이 실패합니다
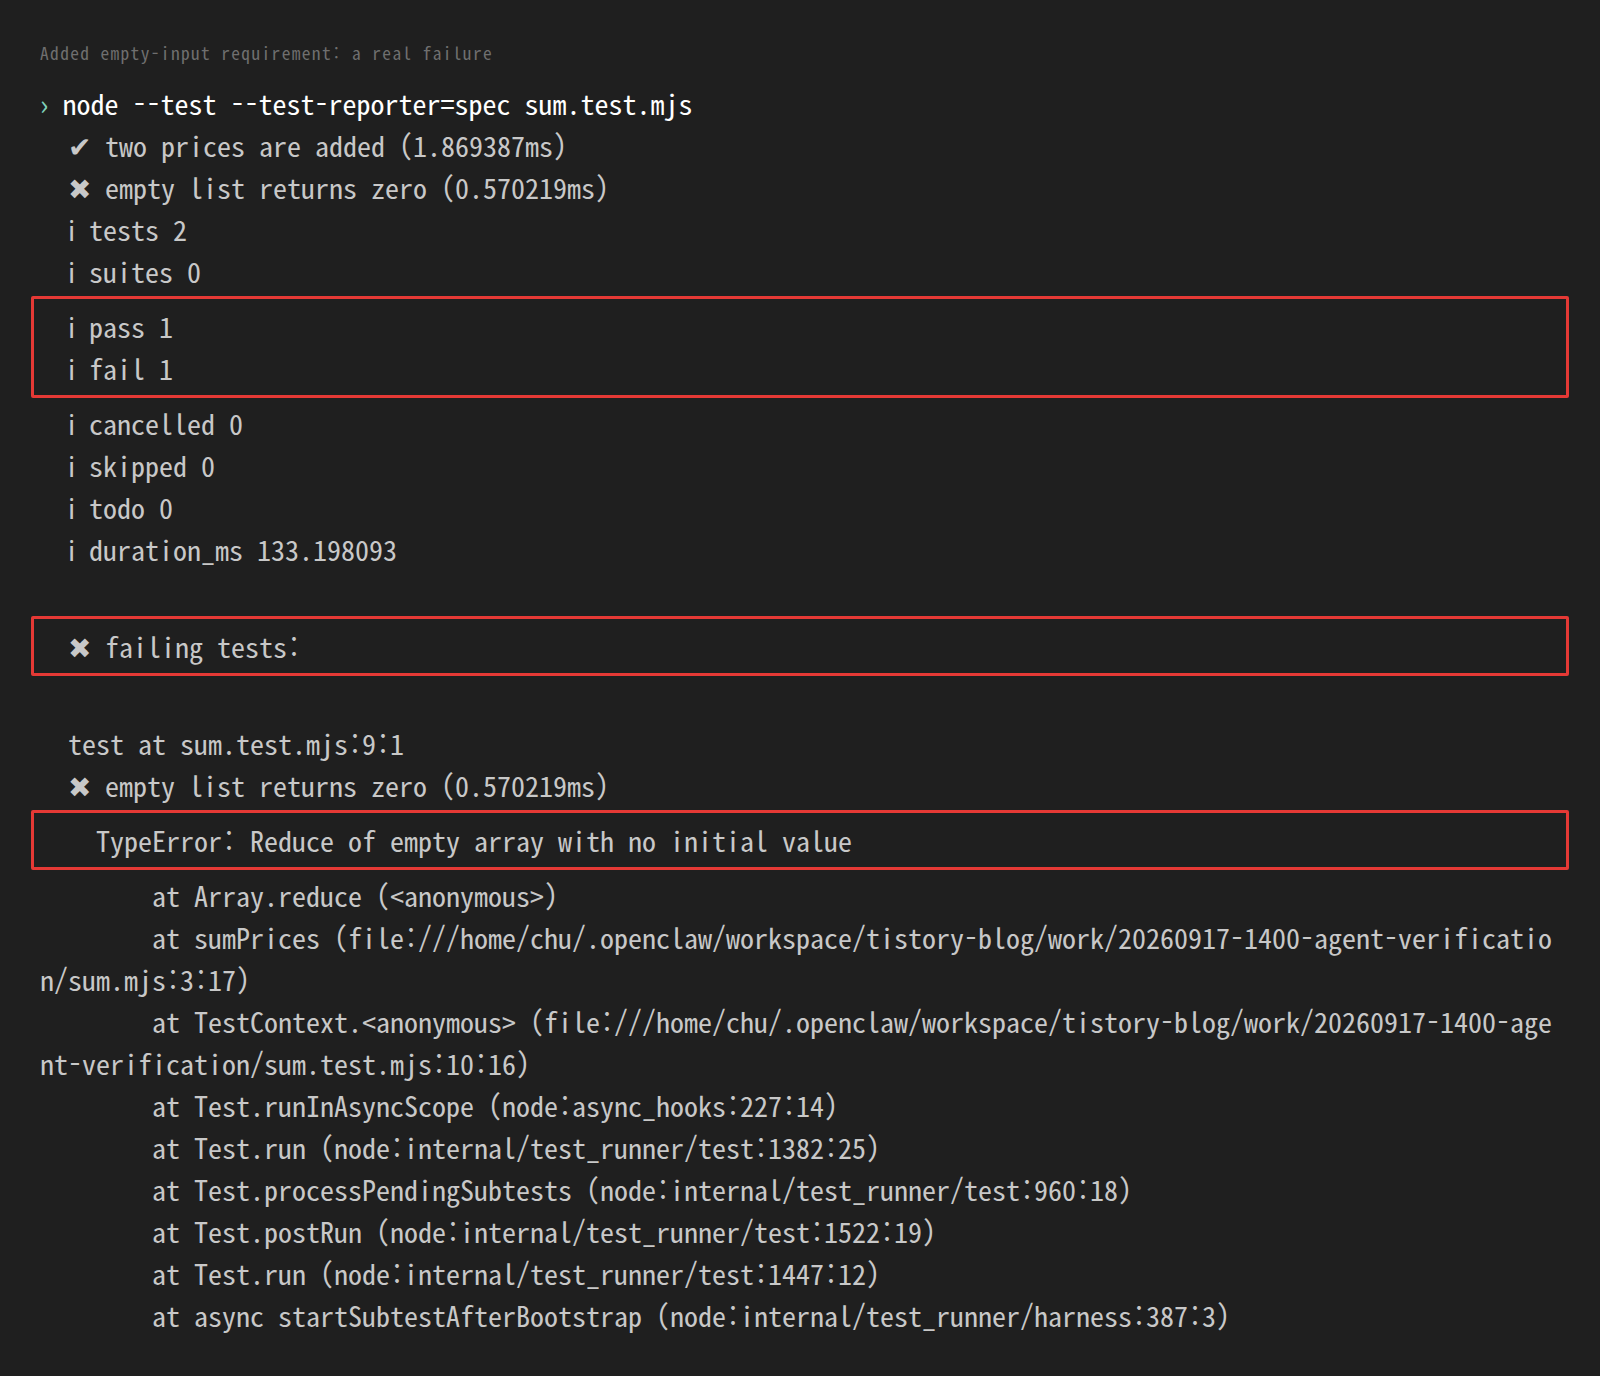
빈 목록 검사를 추가해 재실행했습니다. 결과는 통과 1개·실패 1개였으며, 오류는 TypeError: Reduce of empty array with no initial value였습니다.
test('empty list returns zero', () => {
  assert.equal(sumPrices([]), 0);
});

// sum.mjs의 return 문을 다음처럼 수정
return prices.reduce((total, price) => total + price, 0);
초기값 0을 추가한 뒤 두 테스트를 재실행해 통과 2개·실패 0개와 종료 코드 0을 확인했습니다. 이는 이 두 조건의 충족만 입증합니다. 문자열 입력 처리, 통화 반올림, 저장·화면 표시 등은 이번 예제의 범위가 아니므로 검증했다고 주장하지 않습니다.
| 실행 단계 | 검사 범위 | 실제 결과 |
|---|---|---|
| 초기 구현 | 정상 숫자 목록 | 통과 1 · 실패 0 |
| 구현 유지·검사 추가 | 정상 목록 + 빈 목록 | 통과 1 · 실패 1 |
| 초기값 0 추가 | 동일한 두 검사 | 통과 2 · 실패 0 |
5. 코드 검사·모델 평가·사람 검토는 어떻게 나누나?
명확한 조건은 코드 기반 검사에 맡깁니다
정답이 명확한 반환값, 타입, 접근 권한, 저장 결과는 자동 검사와 잘 맞습니다. 다만 문자열이 완전히 같아야 한다는 검사처럼 기준을 지나치게 좁히면 다른 방식의 올바른 해법을 실패로 처리할 수 있습니다.
| 검사 방식 | 잘 맞는 질문 | 남는 한계 |
|---|---|---|
| 코드 기반 | 요구한 값·상태·규칙을 만족하나? | 검사하지 않은 조건은 놓침 |
| 모델 기반 | 설명·코드 품질이 명시한 기준에 맞나? | 판정 변동과 사람 기준 보정 필요 |
| 사람 검토 | 사용자가 원한 해결과 경험인가? | 시간과 검토 비용이 듦 |
자유로운 결과물은 평가 기준과 표본 검토를 붙입니다
리팩터링의 가독성이나 안내 문구의 적절성처럼 단일 정답이 없는 항목은 명시적 평가 기준을 둔 모델 판정이 보조할 수 있습니다. 사람 채점으로 보정하고 중복·오류 처리·요청 범위 이탈을 나누어 평가하면 판정 이견을 추적하기 쉽습니다.
6. 테스트가 통과해도 실패하는 조건은 무엇인가?
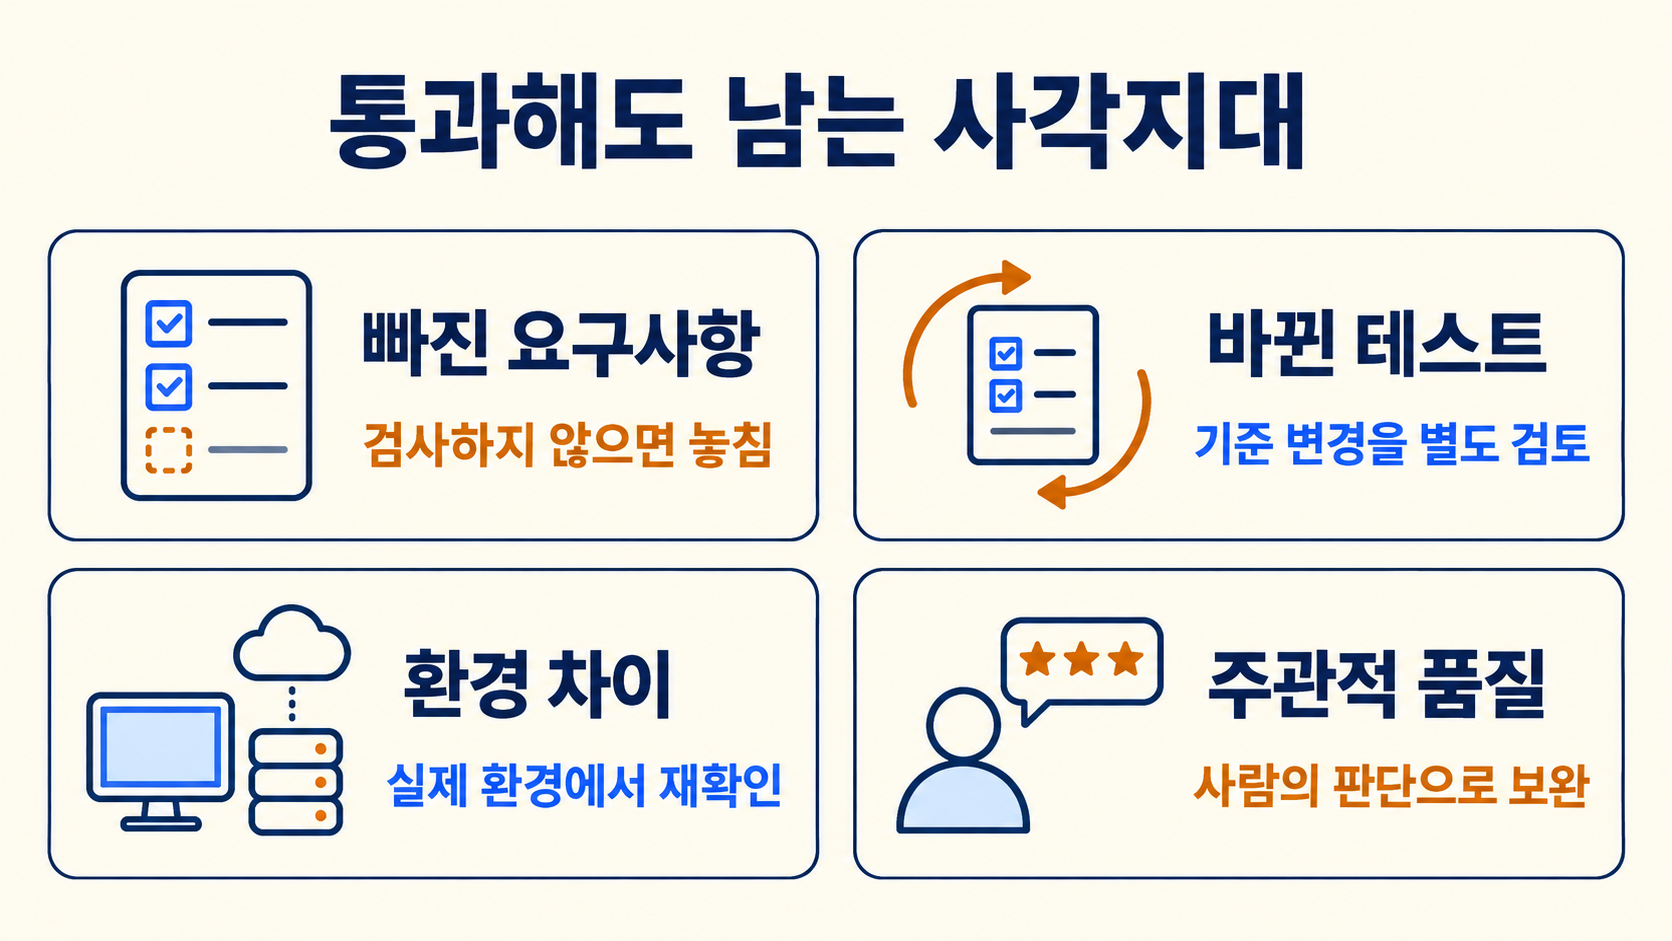
검사 기준 변경과 환경 차이를 분리합니다
에이전트가 구현과 테스트를 모두 수정할 수 있으면 요구사항을 만족시킨 것인지 기대값을 낮춘 것인지 구분해야 합니다. 테스트 수정 자체를 금지할 필요는 없지만, 삭제·건너뜀·기대값 변경은 별도 검토 대상으로 남기는 편이 안전합니다. 로컬 성공 후 배포 환경에서 실패하는 경우에는 의존성·권한·외부 서비스 상태를 비교해야 합니다.
단위 테스트만으로 사용자 흐름을 대체하지 않습니다
장기 실행 하네스 문서는 단위 테스트나 서버 요청 확인을 했어도 웹앱 기능이 끝까지 작동하지 않는 사례를 설명합니다. 해당 실험에서는 브라우저로 사용자의 동작을 따라 검사하도록 명시했을 때 코드만으로 보이지 않던 문제를 찾는 데 도움이 됐습니다. 저장 기능이라면 버튼 클릭, 성공 응답, 다시 조회한 값이 이어지는 흐름이 실제 검토 대상입니다.
검증 루프는 보안 경계가 아닙니다. 테스트를 실행하는 프로세스도 코드를 실행하므로, 신뢰하지 않는 작업물은 운영 자격증명과 분리된 환경에서 다뤄야 합니다. 채점에서 통과했다는 이유로 배포·결제 같은 외부 작업 권한까지 자동으로 넓히지 않습니다.
7. 실무에 적용할 때 무엇부터 기록할까?
최근 실패 사례를 작은 회귀 검사로 만듭니다
실제로 발생한 실패에서 입력, 기대 결과, 재현 조건을 추려 고정합니다. Anthropic은 새로운 능력을 확인하는 capability 평가와 기존 동작을 지키는 regression 평가를 구분합니다.
완료 기록을 다음 실행이 재확인할 수 있게 남깁니다
- 요구사항과 연결된 검사 이름을 기록합니다.
- 대상 코드 버전과 실행 명령을 함께 보존합니다.
- 통과·실패·건너뜀 수, 종료 코드, 실패 로그 위치를 남깁니다.
- 필요한 화면·저장 상태 확인과 수행 환경을 적습니다.
- 검사하지 못한 조건과 사람 검토가 필요한 항목을 구분합니다.
이 목록은 공식 제품의 필수 설정이 아니라, 문서의 평가 원칙을 작업 기록에 적용한 운영 제안입니다.
8. Q&A와 정리
Q1. 새 모델로 바꿀 때 검사도 전부 새로 만들어야 하나요?
기존 요구사항이 유지된다면 회귀 검사도 비교 기준으로 유지할 수 있습니다. 새 모델이 잘하는 영역을 탐색하는 과제는 별도 묶음으로 추가해, 기존 기능의 퇴행과 신규 능력을 나누어 봅니다.
Q2. 에이전트를 몇 번 실행해야 신뢰성을 판단할 수 있나요?
모든 작업에 통하는 횟수는 이 글의 자료와 실험에서 확정할 수 없습니다. 모델 출력은 실행마다 달라질 수 있으므로 실제로 중요한 과제에 여러 trial을 두고, 비용과 허용 실패 수준에 맞게 설계해야 합니다.
Q3. 외부 API 장애로 실패한 실행도 모델 실패인가요?
원인을 구분하지 않으면 모델이 바뀌어서 악화됐는지 외부 환경이 달라졌는지 판단하기 어렵습니다. 장애·시간 초과·권한 문제는 별도 원인으로 기록하되, 사용자 관점에서 작업이 완료되지 않았다는 사실도 함께 남깁니다.
Q4. 통과율이 높은 테스트는 이제 버려도 되나요?
새 능력을 구별하는 시험으로는 덜 유용해져도 회귀 방지에는 쓰일 수 있습니다. 실행 비용이 크다면 중요한 사용자 경로와 최근 변경 영역을 고려해 실행 주기를 정하되, 높은 통과율만을 이유로 제거하지 않습니다.
Q5. 이번 예제로 실제 결제 합계를 구현해도 되나요?
아니요. 정수 배열과 빈 배열의 동작만 보여 준 교육용 코드이며, 실제 금액 계산에 필요한 통화 단위·정밀도·세금·환불 규칙은 다루지 않았습니다.
검사 범위와 미확인 항목을 기록해 다음 수정의 출발점으로 삼으세요.
9. 참고 자료
- Anthropic — Demystifying evals for AI agents: outcome·transcript, 채점 방식과 평가 설계.
- Anthropic — Effective harnesses for long-running agents: 기능 목록·진행 기록·엔드투엔드 테스트 실험.
- Node.js v24 계열 — Test runner: node:test와 명령행 테스트 실행. 본문 실행 환경은 v24.19.0입니다.
'AI Agent' 카테고리의 다른 글
| AI 에이전트 컨텍스트 압축, 무엇을 남겨야 할까? (0) | 2026.09.20 |
|---|---|
| AI 에이전트 재시도 중복 실행 방지: 멱등성 설계 (0) | 2026.09.18 |
| Claude Smart reports 비용·권한·분석 범위 정리 (1) | 2026.09.14 |
| MCP Elicitation 작동 원리: 입력 요청과 URL 승인 차이 (0) | 2026.09.13 |
| Cursor Projects 출시, 코디네이터·공유 문맥·사용 조건 (0) | 2026.09.13 |


