암호화된 LLM 추론 흔적 탈취 — 새 연구가 드러낸 위험
추론 모델의 내부 사고 과정은 보통 사용자에게 그대로 보이지 않습니다. 대신 일부 API는 다음 요청에서도 추론 맥락을 이어가기 위해 암호화된 추론 블록을 클라이언트에 돌려주고, 클라이언트가 이를 후속 요청에 다시 포함하도록 설계합니다. 2026년 8월 10일 공개된 논문 Stealing Reasoning Traces from Proprietary LLM APIs는 이 편의성이 세션·사용자·모델 경계를 넘는 재사용 가능성과 결합할 때 어떤 보안 문제가 생기는지 분석했습니다.
중요한 점은 암호화 자체가 깨졌다는 단순한 이야기가 아니라는 것입니다. 연구진의 핵심 주장은 유효한 암호화 블록을 같은 공급자 생태계 안의 다른 모델에 옮겨 넣을 수 있고, 상대적으로 보호가 약한 모델이 그 내용을 평문으로 재구성하도록 유도할 수 있다는 것입니다. 논문은 OpenAI·Anthropic·Google API를 대상으로 이 공격을 실험했다고 보고합니다.
공격은 어떻게 성립하나
현대 추론 API는 긴 내부 추론을 서버에 계속 보관하는 대신, 서명되거나 암호화된 불투명 블록을 응답에 포함할 수 있습니다. 공식 문서에서도 OpenAI Responses API의 encrypted_content, Google Gemini의 thoughtSignature처럼 암호화된 추론 상태를 다음 호출에 되돌려 보내는 필드를 확인할 수 있습니다.
논문이 지적한 약점은 이 블록의 기밀성보다 사용 범위입니다. 연구진에 따르면 일부 블록은 원래 대화뿐 아니라 다른 세션, 다른 사용자, 같은 공급자의 다른 모델에서도 처리될 수 있었습니다. 공격자는 강한 모델에서 얻은 블록을 호환되는 약한 모델의 입력 문맥에 넣고, 약한 모델을 일종의 불완전한 디코더로 사용합니다. 강한 모델의 보호 장치를 직접 우회하지 않고 모델군 내부의 보호 수준 차이를 이용하는 셈입니다.
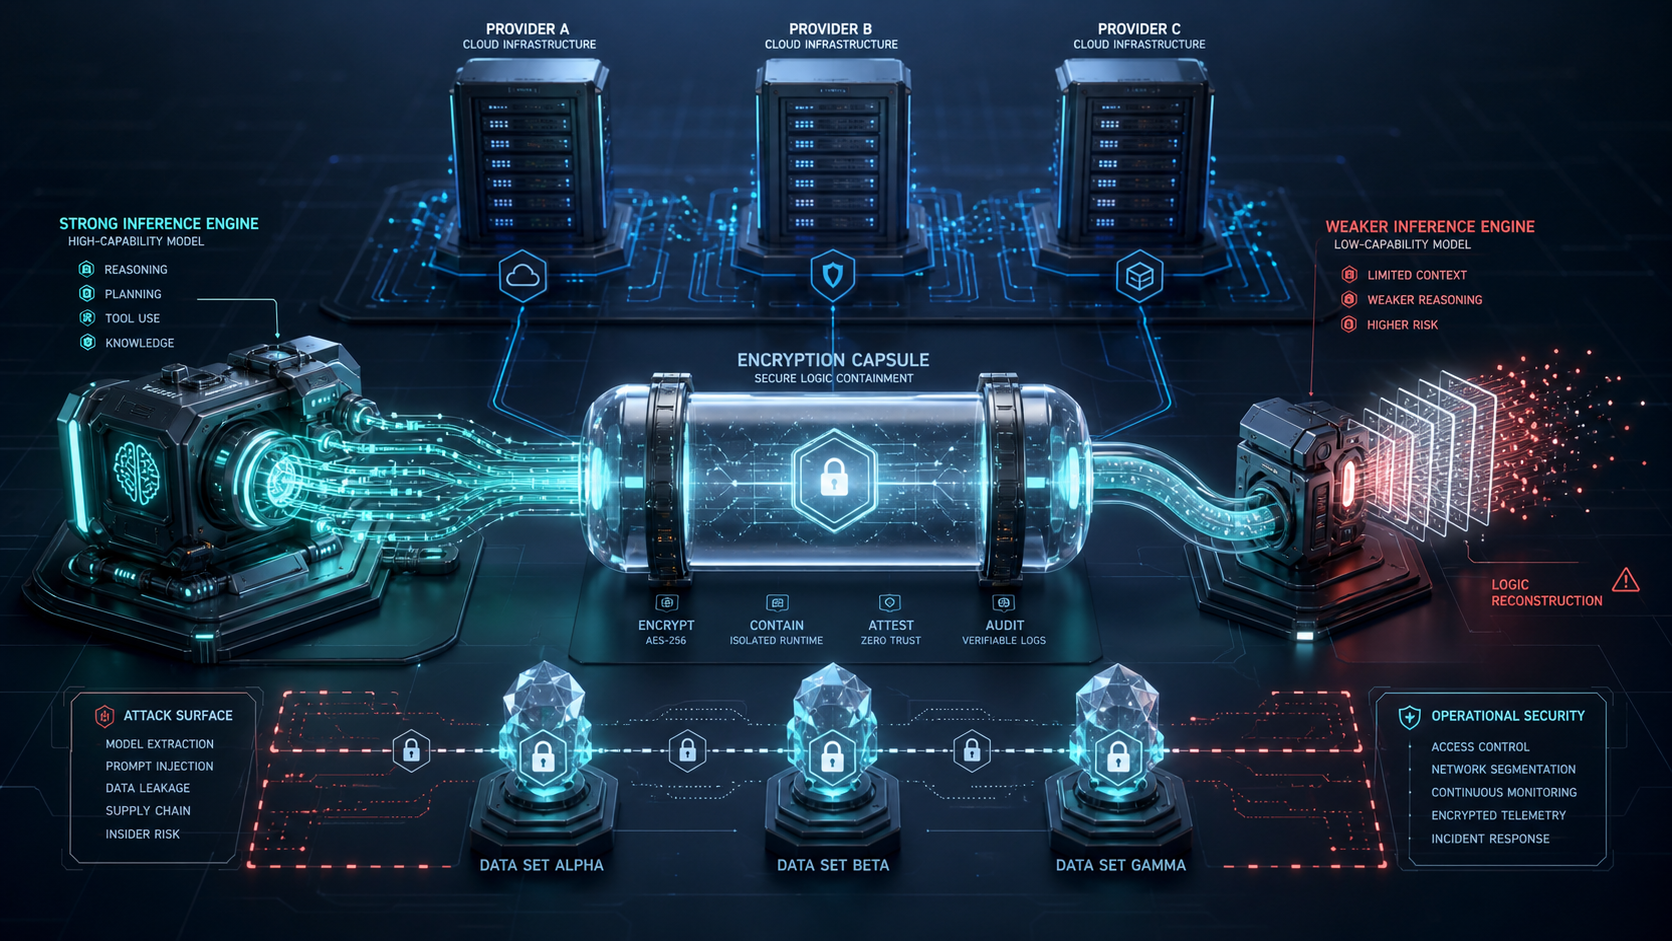
이미지: AI 생성 개념 도해
논문이 제시한 네 가지 위험
- 추론 증류: 최종 답만으로는 얻기 어려운 단계별 문제 해결 흔적을 수집해 다른 모델 학습에 활용할 가능성입니다.
- 민감정보 노출: 공개 저장소에 올라간 에이전트 세션 로그의 암호화 블록에서 개인 식별 정보나 인증정보가 복원될 수 있습니다.
- 유해 정보 노출: 최종 답변이 요청을 거절했더라도 내부 추론에 남은 위험한 내용이 별도 경로로 드러날 수 있습니다.
- 보이지 않는 프롬프트 주입: 사람이 읽기 어려운 암호화 블록 안에 악성 지시를 넣어 장기 실행 에이전트의 후속 행동을 오염시킬 가능성입니다.
연구진은 공개 저장소에서 수집한 추론 블록 315,320개를 분석해 개인 식별 정보 367건과 자격 증명 182건을 복원했다고 보고했습니다. 이 수치는 공급자나 독립 감사기관이 별도로 확정한 통계가 아니라 논문 저자들의 실험 결과라는 점을 구분해서 읽어야 합니다. 또한 저자들은 실제 내부 추론의 정답 원문을 직접 볼 수 없는 경우가 있어, 복원된 결과가 항상 원래 추론과 정확히 일치한다고 보장할 수는 없다고 명시합니다.
개발자가 지금 확인할 것
- 세션 로그를 비밀 데이터로 취급합니다. 불투명한 서명이나 암호문처럼 보여도 공개 저장소, 이슈, 빌드 로그에 그대로 올리지 않는 편이 안전합니다.
- 이미 공개한 로그를 다시 점검합니다. 원문 입력만 지우고 추론 블록을 남겼다면 충분한 비식별화가 아닐 수 있습니다. 노출 가능성이 있다면 관련 API 키와 비밀번호를 폐기·재발급합니다.
- 에이전트 추적 데이터를 최소화합니다. 디버깅에 꼭 필요한 필드만 저장하고, 보관 기간과 접근 권한을 제한합니다.
- 외부에서 받은 추론 블록을 신뢰하지 않습니다. 공유된 에이전트 기록이나 벤치마크 데이터를 재생할 때는 별도 격리 환경과 도구 권한 제한이 필요합니다.
공급자 측 대응으로는 암호화 블록을 특정 사용자·세션·모델·대화 순서에 묶는 컨텍스트 바인딩, 오래된 블록의 폐기와 철회, 모델 간 호환 범위 축소가 논문에서 논의됩니다. 다만 이런 변경은 모델 전환과 상태 없는 API 운영의 편의성을 줄일 수 있어 보안과 호환성 사이의 설계 선택이 필요합니다.
과장 없이 읽어야 할 부분
이번 결과는 모든 암호화 추론 API가 언제나 같은 방식으로 뚫린다는 일반 증명은 아닙니다. 연구진이 2026년 7월 무렵 시험한 특정 모델·API 조합의 호환성과 모델 행동에 의존합니다. 공급자가 서버 측 검증이나 모델 호환 정책을 바꾸면 재현 가능성도 달라질 수 있습니다. 반대로 개발자 관점에서는 암호문이라는 외형만 보고 로그를 안전하다고 판단해서는 안 된다는 교훈이 남습니다.
Threads의 AI 커뮤니티에서도 이 논문이 빠르게 공유되고 있지만, 화제성 높은 요약에는 공격 범위와 검증 한계가 생략되기 쉽습니다. 실무자는 논문 초록만이 아니라 위협 모델, 한계, 완화책을 함께 읽고 대응 범위를 정하는 것이 좋습니다.
마무리
이 연구가 보여주는 핵심은 보안 경계가 암호 알고리즘 하나로 끝나지 않는다는 사실입니다. 암호화된 상태가 어디서, 누구에 의해, 어떤 모델로 재사용될 수 있는지가 기밀성만큼 중요합니다. 에이전트 도구를 운영한다면 세션 로그를 소스 코드와 같은 공개 가능한 산출물이 아니라 자격 증명에 가까운 민감 자산으로 분류하고, 저장·공유·폐기 정책부터 다시 확인할 시점입니다.
참고 자료
'LLM' 카테고리의 다른 글
| DeepSeek V4-Pro 0813 해설 — 에이전트 도입 체크리스트 (0) | 2026.08.13 |
|---|---|
| Grok 4.6 기술 해설 — 장시간 에이전트 성능과 한계 (1) | 2026.08.13 |
| DiffusionGemma 기술 해설 — 4배 빠른 생성의 조건과 한계 (0) | 2026.08.11 |
| LLMWiki와 온톨로지 3편 — 실제 구축과 운영 가이드 (0) | 2026.08.10 |
| 온톨로지 완전 입문 2편 — 개념·관계·규칙으로 지식을 설계하기 (0) | 2026.08.10 |


