Recurrent Looped Transformer란? RLT 구조·실행 결과
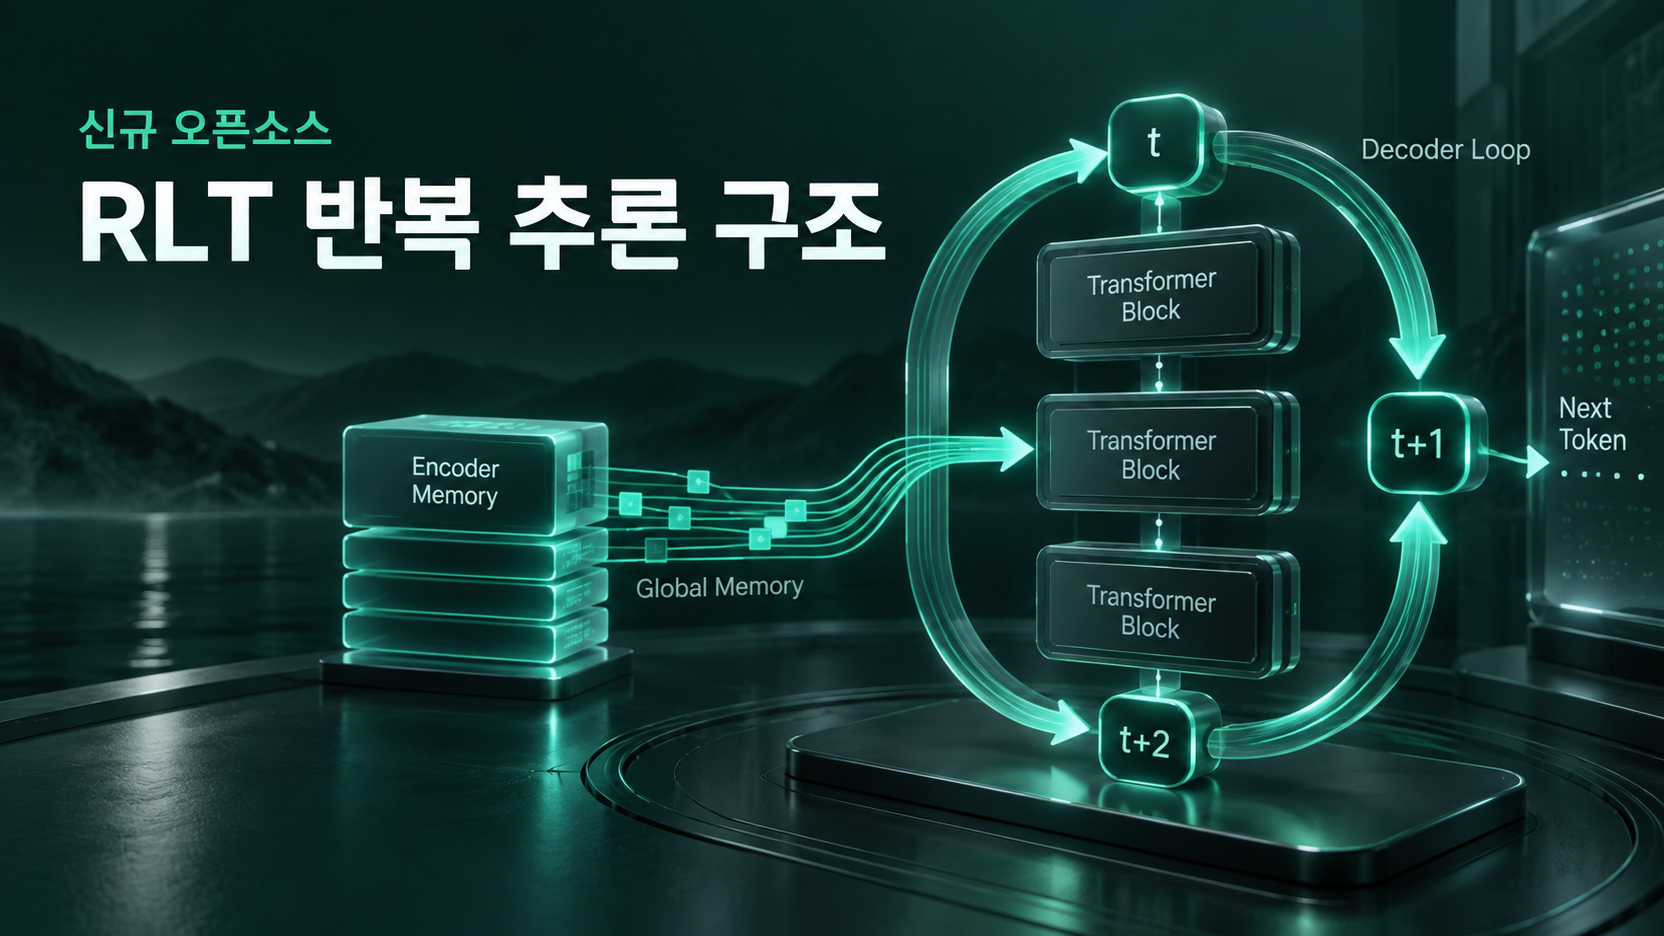
Recurrent Looped Transformer(RLT)는 토큰이 바뀔 때마다 디코더의 마지막 은닉 상태와 슬라이딩 윈도우 KV 캐시를 다음 토큰으로 넘기는 새 트랜스포머 구조입니다. 2026년 9월 16일 기준 공식 기술 보고서는 초기 실험 결과까지 공개했으며, 비공식 PyTorch 구현은 CPU에서도 기본 경로의 순전파·역전파·생성이 작동했습니다. 다만 기존 Transformer를 대체한다고 결론 내리기에는 실험 규모와 구현 성숙도가 아직 부족합니다.
이 글은 9월 12일 공개되고 9월 15일 개정된 RLT 기술 보고서[2], 공식 프로젝트 저장소[3], RLT-pytorch 구현[4]을 기준으로 작성했습니다.
- RLT가 고정 깊이 Transformer와 달라지는 지점
- 인과적 인코더·전역 메모리·순환 디코더의 역할
- 로컬 CPU에서 확인한 설치와 실행 결과
- FlexAttention CPU 역전파 제한과 초기 실험의 범위
- 현재 적용해 볼 만한 대상과 보류해야 할 조건
RLT의 “무한 깊이”는 한 토큰에서 계산을 무한히 반복한다는 뜻이 아닙니다. 시퀀스가 길어질수록 토큰 간 순환 경로가 계속 연장된다는 의미이며, 토큰 하나가 실행하는 블록 수는 고정됩니다. 공식 보고서도 실제 추론 품질과 하드웨어 효율의 우위를 확정된 사실로 제시하지 않습니다.
공식 원문: Recurrent Looped Transformer 프로젝트 페이지[1]
1. Recurrent Looped Transformer는 무엇이 다른가
고정된 층 깊이 대신 토큰 사이에 상태를 이어 줍니다
일반적인 디코더 전용 Transformer에서는 각 토큰이 정해진 수의 층을 통과합니다. 이전 정보는 KV 캐시로 전달되지만, 마지막 디코더 출력 자체가 다음 토큰의 첫 입력으로 직접 이어지지는 않습니다.
RLT는 이 연결을 닫습니다. 현재 토큰의 인코더 표현과 직전 토큰에서 나온 최종 디코더 상태를 게이트로 합친 뒤, 같은 디코더 전이를 다시 적용합니다. 따라서 토큰 t까지 처리했을 때 순환 경로는 t × L_D개의 디코더 블록을 지난 것으로 볼 수 있습니다.[1][2]
“무한 깊이”보다 “연장 가능한 시간 깊이”가 정확합니다
시퀀스 길이가 늘어나면 계산 경로도 계속 길어지므로 아키텍처가 정한 고정 상한은 없습니다. 그러나 유한한 문장은 언제나 유한한 연산만 수행하고, 토큰당 실행량도 고정됩니다. 공식 예시인 48층 인코더와 48층 디코더 구성은 토큰마다 96개의 논리 블록을 평가하면서 디코더 순환 경로만 토큰 수에 따라 늘어납니다.[1]
2. RLT 구조는 인코더 메모리와 두 종류의 상태로 나뉩니다
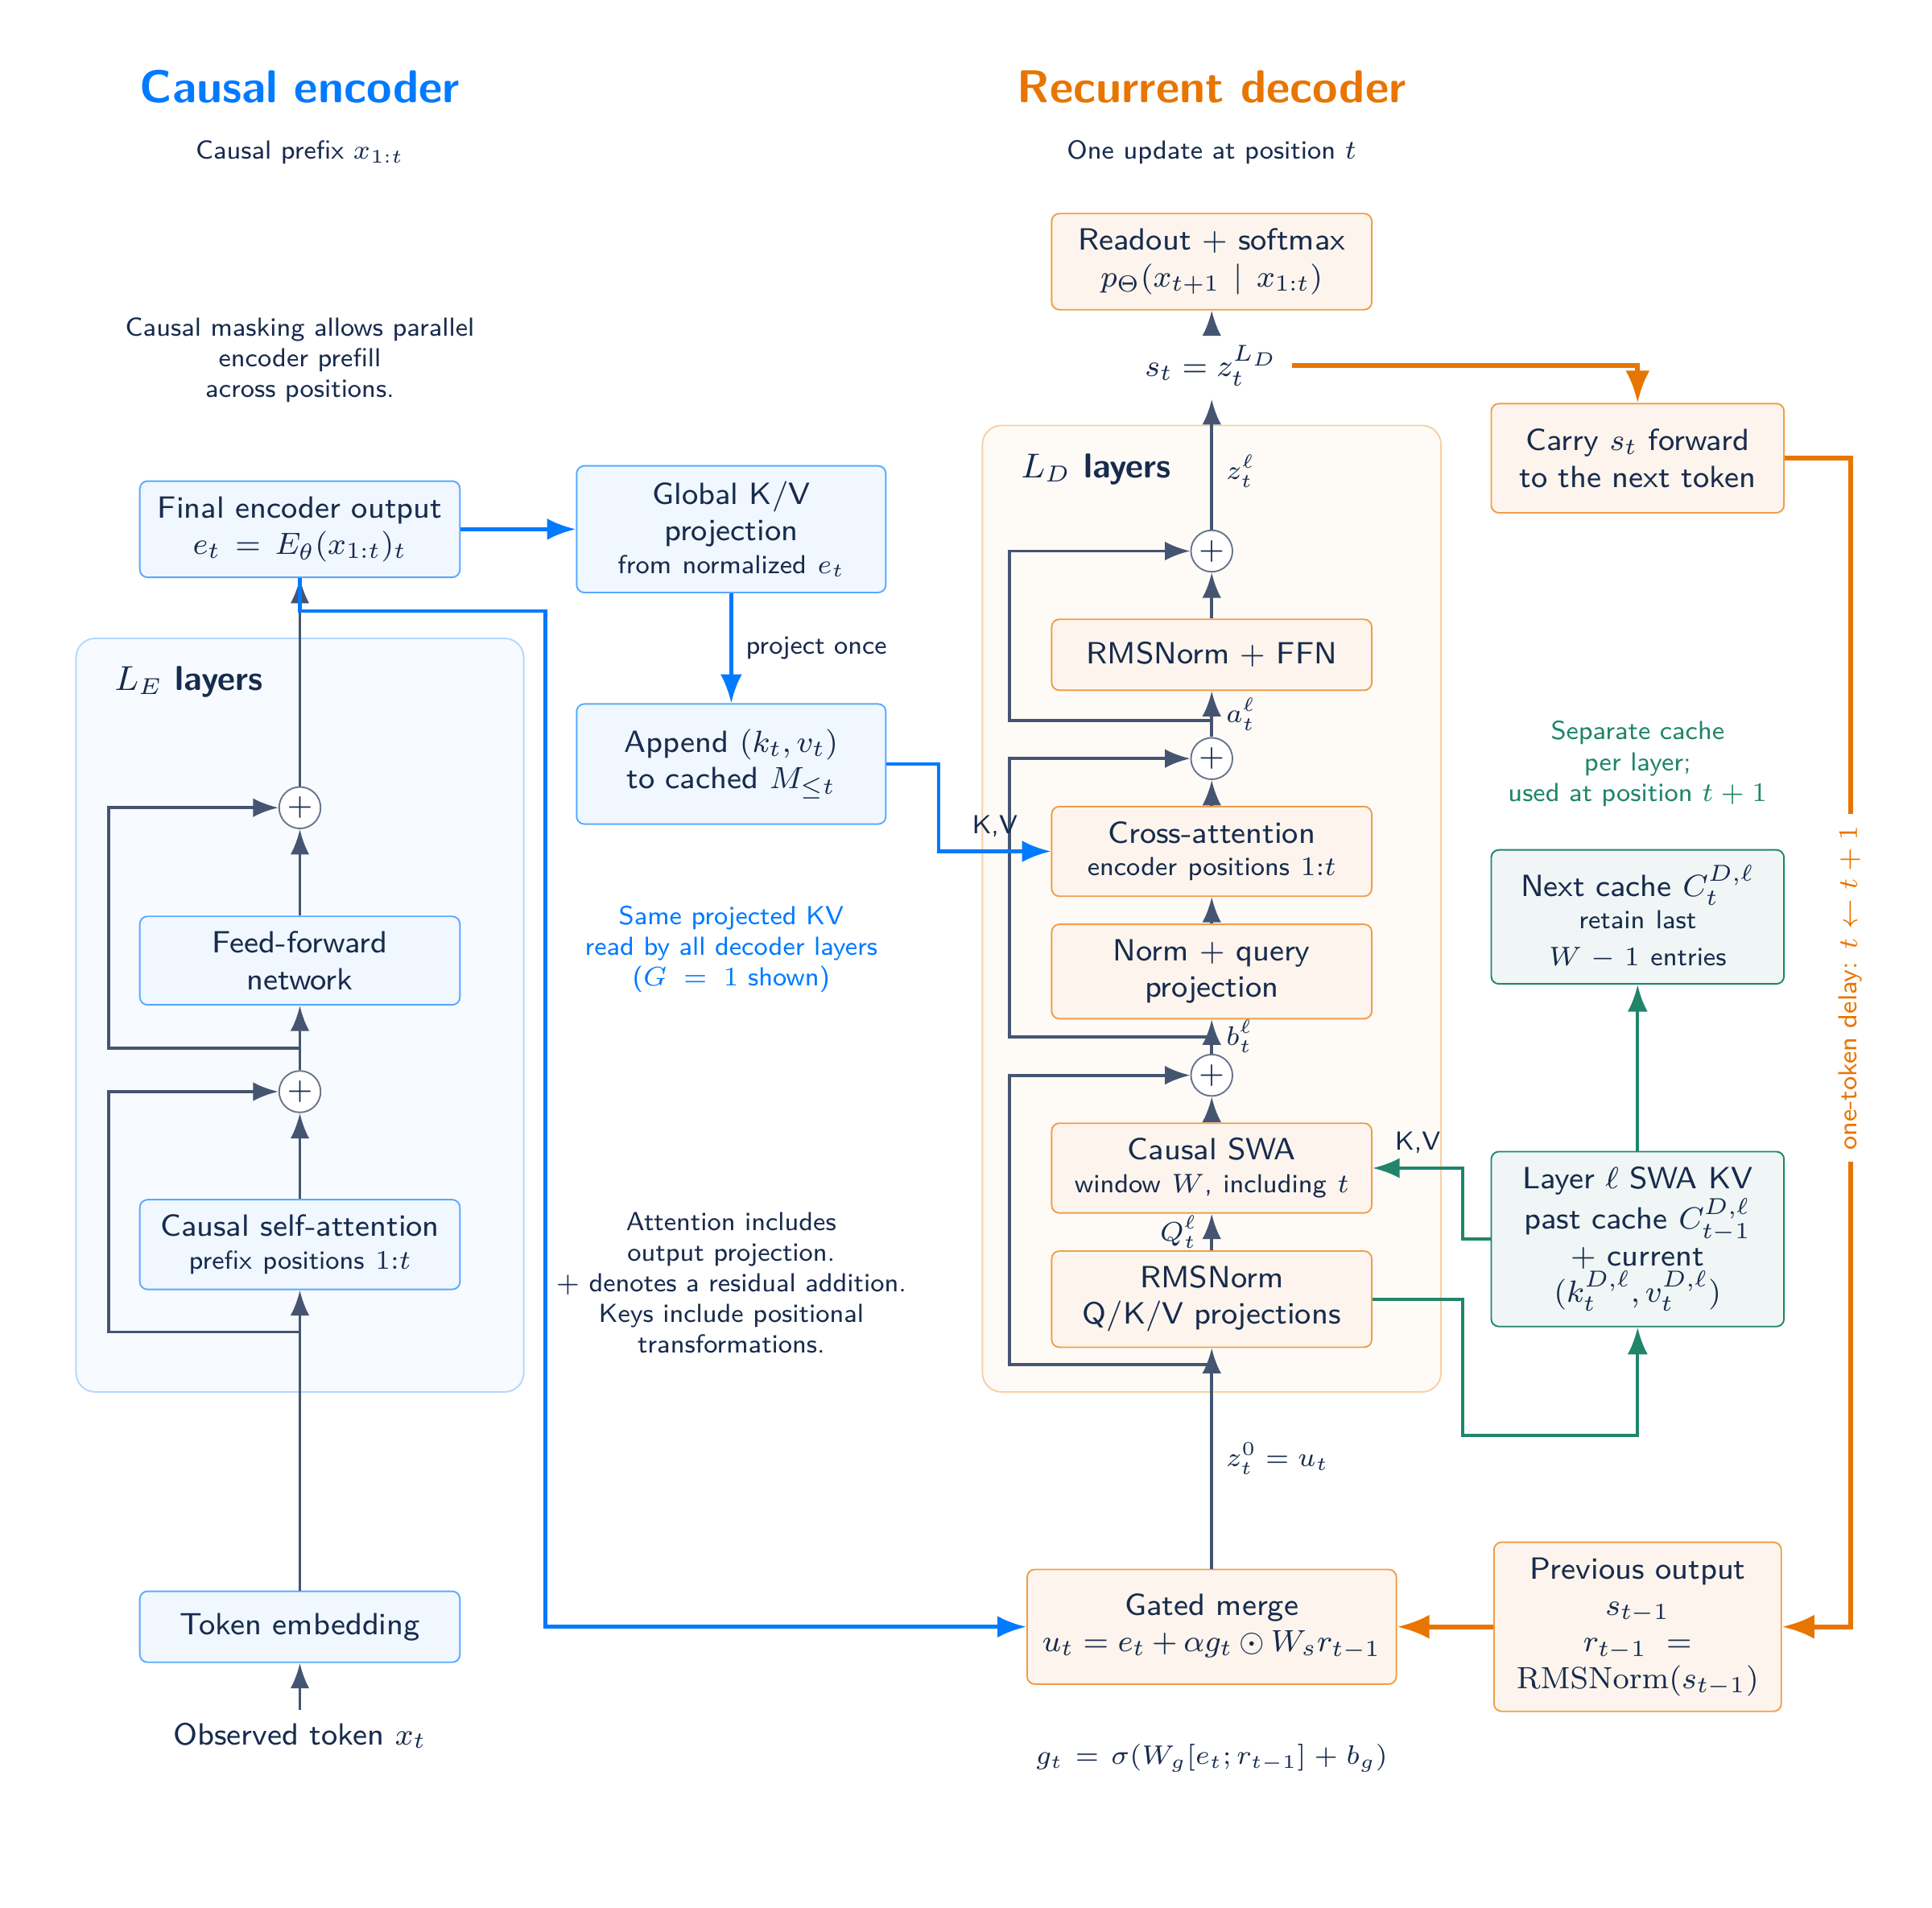
출처: Recurrent Looped Transformer 공식 저장소 · Apache-2.0
출처: https://github.com/yifanzhang-pro/recurrent-looped-tranformer/blob/master/assets/architecture-detail.png · 라이선스: Apache-2.0
인과적 인코더가 전역 KV 메모리를 만듭니다
인코더는 현재 위치까지의 토큰을 인과적 마스크로 처리해 표현 e_t를 만들고, 이를 전역 key-value 메모리로 투영합니다. 이미 알려진 프롬프트 토큰은 인코더 단계에서 병렬로 처리할 수 있으며, 디코더의 cross-attention은 현재 위치까지 허용된 전역 메모리를 읽습니다.
디코더는 은닉 상태와 층별 SWA 캐시를 함께 넘깁니다
완전한 디코더 상태 H_t는 마지막 출력 s_t와 각 디코더 층의 sliding-window attention 캐시 C_t^D로 구성됩니다. 전역 메모리는 긴 문맥을 제공하고, SWA 캐시는 최근 토큰의 로컬 문맥을 제한된 창 안에서 보존합니다.
프롬프트와 응답 경계에서 상태를 초기화하지 않습니다
RLT는 프롬프트 처리와 응답 생성에 같은 전이를 사용합니다. 마지막 프롬프트 토큰 뒤에서 은닉 상태나 SWA 캐시를 리셋하지 않으므로, 서빙 경계가 달라져도 같은 토큰 이력과 실행 규칙이라면 다음 토큰 분포가 같아야 한다는 것이 설계의 핵심입니다.[2]
3. 추론 구조와 하드웨어·강화학습 설계가 연결되는 이유
인코더는 병렬화할 수 있지만 디코더 상태는 순서대로 갱신됩니다
인코딩과 전역 메모리 투영은 묶어서 처리할 수 있지만, 순환 디코더는 앞 상태가 필요해 토큰 순서를 따라야 합니다. 여러 독립 시퀀스는 배치로 묶을 수 있어도 한 시퀀스 내부 의존성은 남습니다.
따라서 연산량만으로 속도를 단정할 수 없습니다. 긴 프롬프트의 순차 prefill과 작은 배치는 가속기 활용률을 낮추는 반면, 가중치 공유와 메모리 재사용은 저장량을 줄일 수 있습니다.
RL replay에서는 전체 상태를 현재 가중치로 다시 만들어야 합니다
정책을 업데이트한 뒤 예전 캐시를 그대로 사용하면 현재 정책의 상태라고 볼 수 없습니다. 보고서는 프롬프트와 응답 전체를 현재 파라미터로 다시 실행해 은닉 상태·SWA KV·인코더 메모리를 재구성해야 한다고 설명합니다. 이는 샘플링과 학습 사이의 구조적 불일치를 줄이려는 설계이지, 오프폴리시 추정이나 수치 커널 차이까지 자동으로 해결한다는 뜻은 아닙니다.[1][2]
4. RLT-pytorch 설치와 CPU 실행 조건
Python 3.10 이상과 PyTorch 2.5 이상이 필요합니다
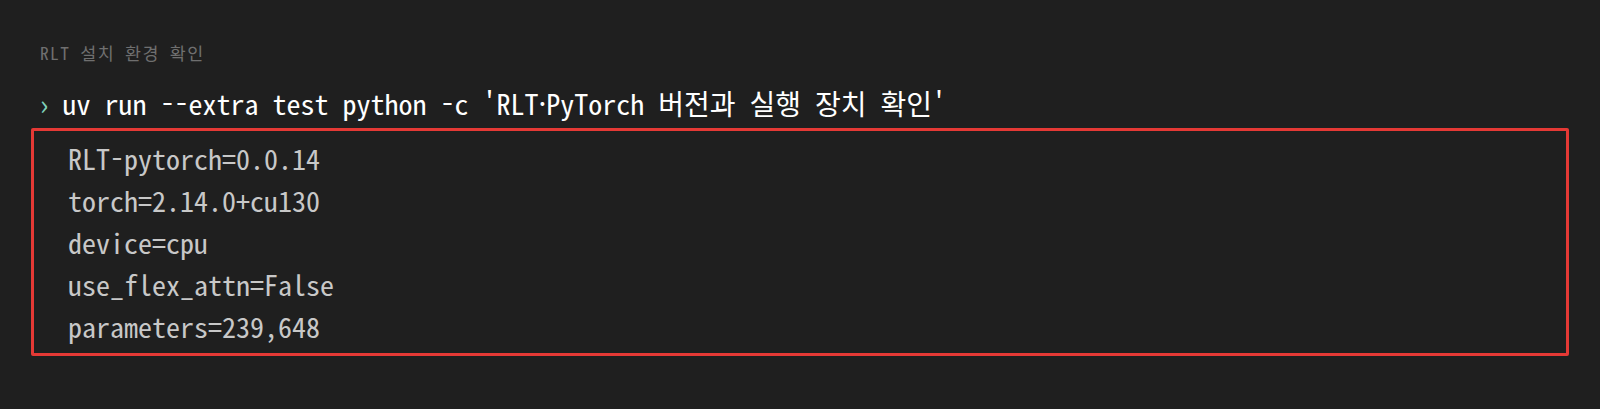
RLT-pytorch는 MIT 라이선스이며 Python 3.10 이상, PyTorch 2.5 이상을 요구합니다.[4][5] 검증 환경은 커밋 f9fad931, 패키지 0.0.14, Python 3.11.16입니다.
git clone https://github.com/lucidrains/RLT.git
cd RLT
uv run --extra test pytest -q
CPU에서는 기본 attention 경로를 사용합니다
RLT 생성자의 use_flex_attn 기본값은 False입니다. CPU에서 학습용 역전파를 확인하려면 이 기본값을 유지해야 합니다.
import torch
from RLT import RLT

model = RLT(
    num_tokens=32,
    dim=64,
    enc_depth=2,
    dec_depth=2,
    heads=4,
    dim_head=16,
    dec_sliding_window_size=4,
    use_flex_attn=False,
)

tokens = torch.randint(0, 32, (2, 16))
loss = model(tokens, return_loss=True)
loss.backward()
5. 직접 실행 결과: 손실·역전파·생성이 작동했습니다
작은 CPU 모델에서 수치가 정상적으로 계산됐습니다
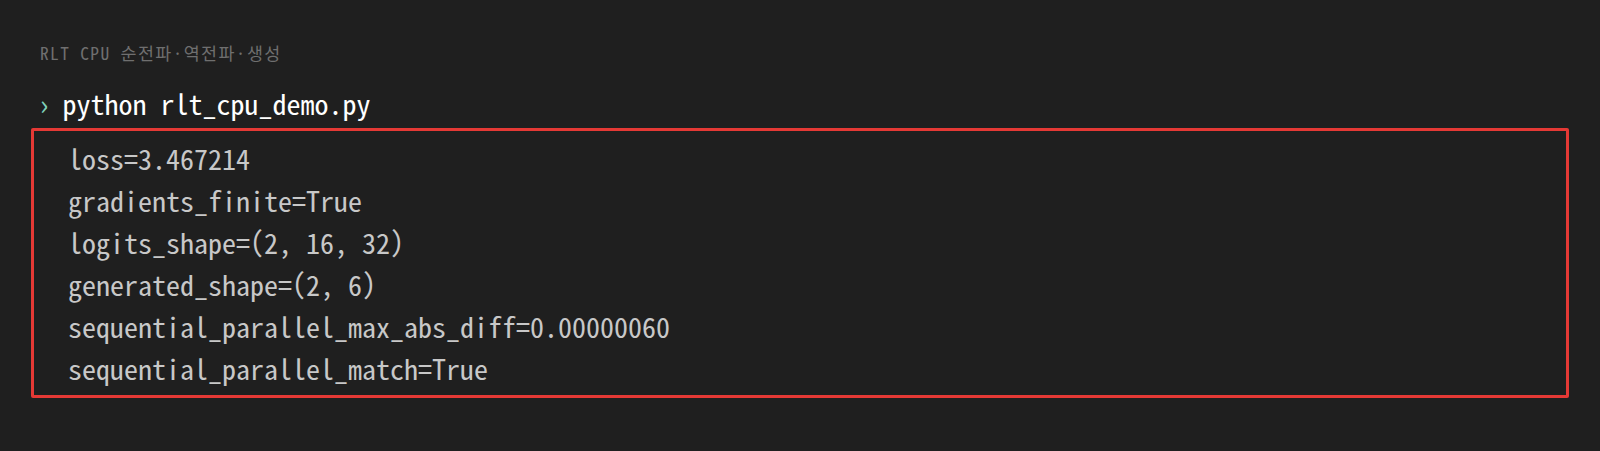
어휘 32개, 차원 64, 인코더·디코더 각 2층인 239,648 파라미터 모델을 실행했습니다. 손실은 3.467214, gradient 유한값 검사는 True였습니다. logits는 (2, 16, 32), 생성된 신규 토큰은 (2, 6) 형태였습니다.
병렬 처리와 토큰별 순차 처리 결과도 일치했습니다
동일한 16토큰 입력을 한 번에 처리한 결과와, 메모리를 넘기며 한 토큰씩 처리한 결과를 비교했습니다. 최대 절댓값 차이는 0.00000060이었고, 허용 오차 1e-5에서 torch.allclose가 True를 반환했습니다. 최소 구현 수준에서는 보고서가 요구하는 상태 연속성이 재현됐다는 뜻입니다.
이 실행은 모델 품질이나 장문 추론 성능을 측정한 벤치마크가 아닙니다. 설치 가능성, 기본 forward/backward, 생성, 순차·병렬 계산의 수치 일치만 확인한 스모크 테스트입니다.
6. 아직 주의해야 할 실패 조건과 실험 한계
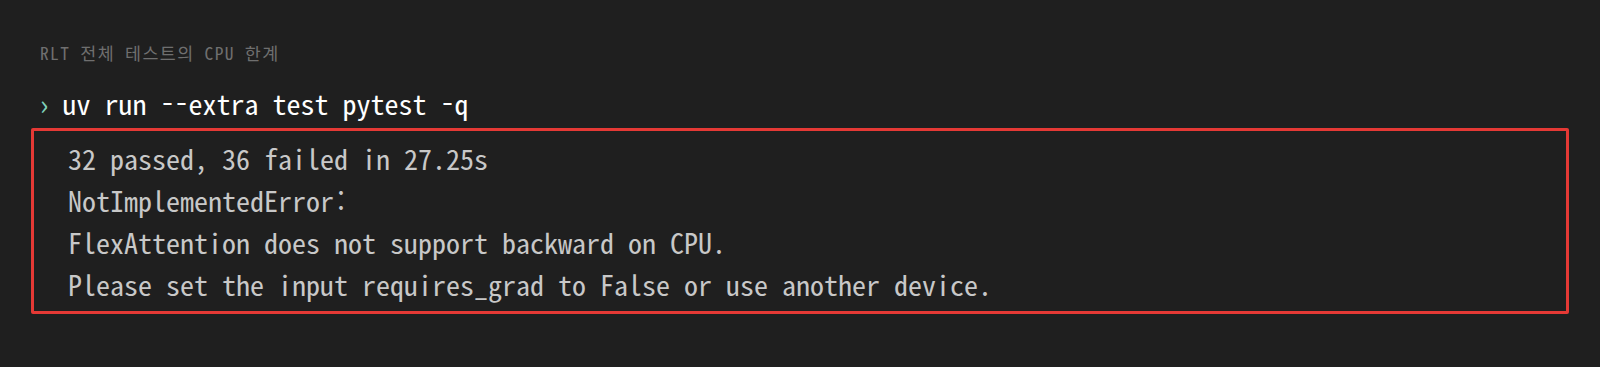
전체 테스트 68개 중 36개가 CPU FlexAttention에서 실패했습니다
저장소의 전체 pytest를 CPU에서 실행했을 때 32개가 통과하고 36개가 실패했습니다. 실패는 use_flex_attn=True 조합에서 PyTorch가 FlexAttention does not support backward on CPU를 반환한 경우였습니다. CPU에서 RLT 자체가 전혀 작동하지 않는다는 의미는 아니며, 앞서 확인한 기본 use_flex_attn=False 경로는 정상 작동했습니다.
| 실행 조건 | 결과 | 판단 |
|---|---|---|
| CPU + 기본 attention | forward·backward·generate 성공 | 소규모 재현 가능 |
| CPU + FlexAttention backward | NotImplementedError | GPU 또는 기본 경로 필요 |
| 공식 대규모 품질 비교 | 아직 없음 | 우위 확정 불가 |
| 공식 초기 알고리즘 과제 | 과제별 결과 혼재 | 선별적 개선으로 해석 |
공식 결과도 초기 스냅샷이며 과제별 편차가 큽니다
9월 15일 보고서의 8층 비교에서는 일부 RLT 구성이 parity를 더 일찍 학습했고, 완료된 mod-5 비괄호 실험에서 RLT 7+1은 95.44%, GPT 8은 20.57%를 기록했습니다. 반면 괄호가 있는 mod-5에서는 GPT 8이 79.56%로 RLT 7+1의 78.26%보다 약간 높았고, 표준 순열 추적은 모든 모델이 낮았습니다. 실험 48개 중 당시 목표 2,000 step에 도달한 실행이 21개뿐이므로 “RLT가 더 좋다”는 단일 결론으로 압축하면 안 됩니다.[2]
7. 지금 RLT를 써 볼 대상과 비교 기준
연구·프로토타입에는 흥미롭지만 운영 모델 교체용은 아닙니다
순환 깊이·상태 지속·RL replay를 연구한다면 구현을 확인할 가치가 있습니다. 검증된 체크포인트와 GPU 처리량이 필요한 운영 환경은 후속 실험과 최적화 커널을 기다리는 편이 안전합니다.
기존 추론 가속 기법과 해결하는 문제가 다릅니다
RLT는 모델 내부의 상태 전달과 시간 깊이를 바꾸는 아키텍처입니다. 초안 토큰을 병렬로 검증하는 DFlash 2의 병렬 초안 방식이나 MTP와 DFlash 추론 가속 비교처럼 이미 학습된 모델의 디코딩을 빠르게 만드는 기법과는 목적이 다릅니다.
| 접근 | 바꾸는 대상 | 주요 기대 | 현재 확인할 위험 |
|---|---|---|---|
| 일반 Transformer | 고정 층 스택 | 검증된 병렬 학습·서빙 | 토큰 간 계산 깊이 고정 |
| Recurrent Transformer | 층별 recurrent KV | 효과적 깊이·KV 절감 | 새 커널과 학습 검증 필요 |
| RLT | 인코더 메모리 + 최종 상태 + SWA | 연장 가능한 시간 깊이·일관된 replay | 순차 prefill·초기 벤치마크·구현 성숙도 |
도입 전 체크리스트
- 연구 질문이 “더 빠른 디코딩”인지 “토큰 간 상태 누적”인지 구분합니다.
- CPU에서는
use_flex_attn=False로 먼저 스모크 테스트합니다. - 성능 비교는 같은 파라미터 수·학습 예제 수·seed 수로 맞춥니다.
- 프롬프트와 응답 사이에서 은닉 상태와 SWA 캐시가 리셋되지 않는지 확인합니다.
- 가중치 업데이트 뒤 RL replay가 전체 상태를 다시 계산하는지 점검합니다.
8. Q&A와 정리
Q1. RLT는 바로 사용할 수 있는 완성형 언어모델인가요?
아닙니다. 현재 공개된 핵심 산출물은 구조와 초기 알고리즘 실험을 담은 기술 보고서이며, 별도의 PyTorch 구현도 아직 빠르게 갱신되는 초기 프로젝트입니다.
Q2. GPU 없이 설치하고 실행할 수 있나요?
작은 구성과 기본 attention 경로는 CPU에서 실행할 수 있습니다. 다만 FlexAttention 역전파를 포함한 전체 테스트를 CPU만으로 통과시키지는 못했습니다.
Q3. 긴 문장을 넣으면 자동으로 더 똑똑해지나요?
계산 경로가 길어진다는 사실과 추론 품질 향상은 같은 말이 아닙니다. 긴 순환 경로에서 정보를 실제로 보존하고 활용하는지는 학습 결과와 안정성 실험으로 확인해야 합니다.
Q4. Recurrent Transformer와 같은 구조인가요?
관련 계열이지만 동일하지 않습니다. Recurrent Transformer는 층별 recurrent memory에 초점을 두고, RLT는 별도 인코더 메모리와 최종 디코더 상태, 층별 SWA 캐시를 함께 이어 갑니다.[6]
Q5. 지금 가장 먼저 확인할 후속 자료는 무엇인가요?
대규모 언어모델 체크포인트, 동일 연산량 기준 벤치마크, 긴 문맥의 상태 안정성, GPU prefill 처리량, 다중 seed 결과가 우선입니다. 이 자료가 나오기 전에는 유망한 연구 설계로 보되 성능 우위를 확정하지 않는 편이 맞습니다.
RLT의 핵심은 같은 층을 단순 반복하는 데 있지 않고, 전역 인코더 메모리와 연속 디코더 상태를 하나의 실행 규칙으로 묶는 데 있습니다. 현재는 운영 기술보다 검증할 질문이 많은 오픈소스 연구 단계입니다.
9. 참고 자료
'ML & DL' 카테고리의 다른 글
| Google HEIR 동형암호 AI 추론, 어떻게 시작할까? (0) | 2026.08.24 |
|---|---|
| Dyna-2 로봇 스케일링 법칙 — 인간 영상 100만 시간의 의미 (1) | 2026.08.11 |
| NVIDIA RAPIDS가 CUDA-X로 바뀐다 — 26.08 전환 체크리스트 (0) | 2026.08.11 |
| VocalRender 공개 — 악보를 바로 읽는 가창 합성 AI (0) | 2026.08.10 |
| Wan-Animate-2 공개 — 구동 영상을 직접 읽는 캐릭터 애니메이션 AI (0) | 2026.08.10 |


