VocalRender 공개 — 악보를 바로 읽는 가창 합성 AI
가창 합성은 음질만 좋아진다고 작곡 도구가 되지는 않습니다. 실제 작업에서는 가사, 음높이, 음표 길이, 템포가 적힌 악보를 모델이 얼마나 자연스럽게 받아들이는지가 중요합니다. 2026년 7월 공개된 VocalRender는 이 간극을 줄이기 위해 악보 중심(score-native) 입력을 전면에 내세운 연구입니다. 가사와 MIDI 음높이, 4분음표·8분음표 같은 기호적 음가, BPM을 직접 받아 노래를 생성합니다.
기존 가창 합성의 불편은 무엇이었나
기존 시스템 다수는 음소별 길이를 먼저 정하거나, 별도의 duration predictor로 출력 길이를 예측하거나, F0 곡선과 참조 오디오처럼 시간축에 정렬된 안내 신호를 요구합니다. 이런 접근은 제어력이 높지만 작곡가가 쓰는 악보를 다시 프레임 단위 입력으로 가공해야 하는 부담이 생깁니다. 특히 한 음절을 여러 음표에 걸쳐 부르는 멜리스마에서는 가사와 음표의 대응이 모호해질 수 있습니다.
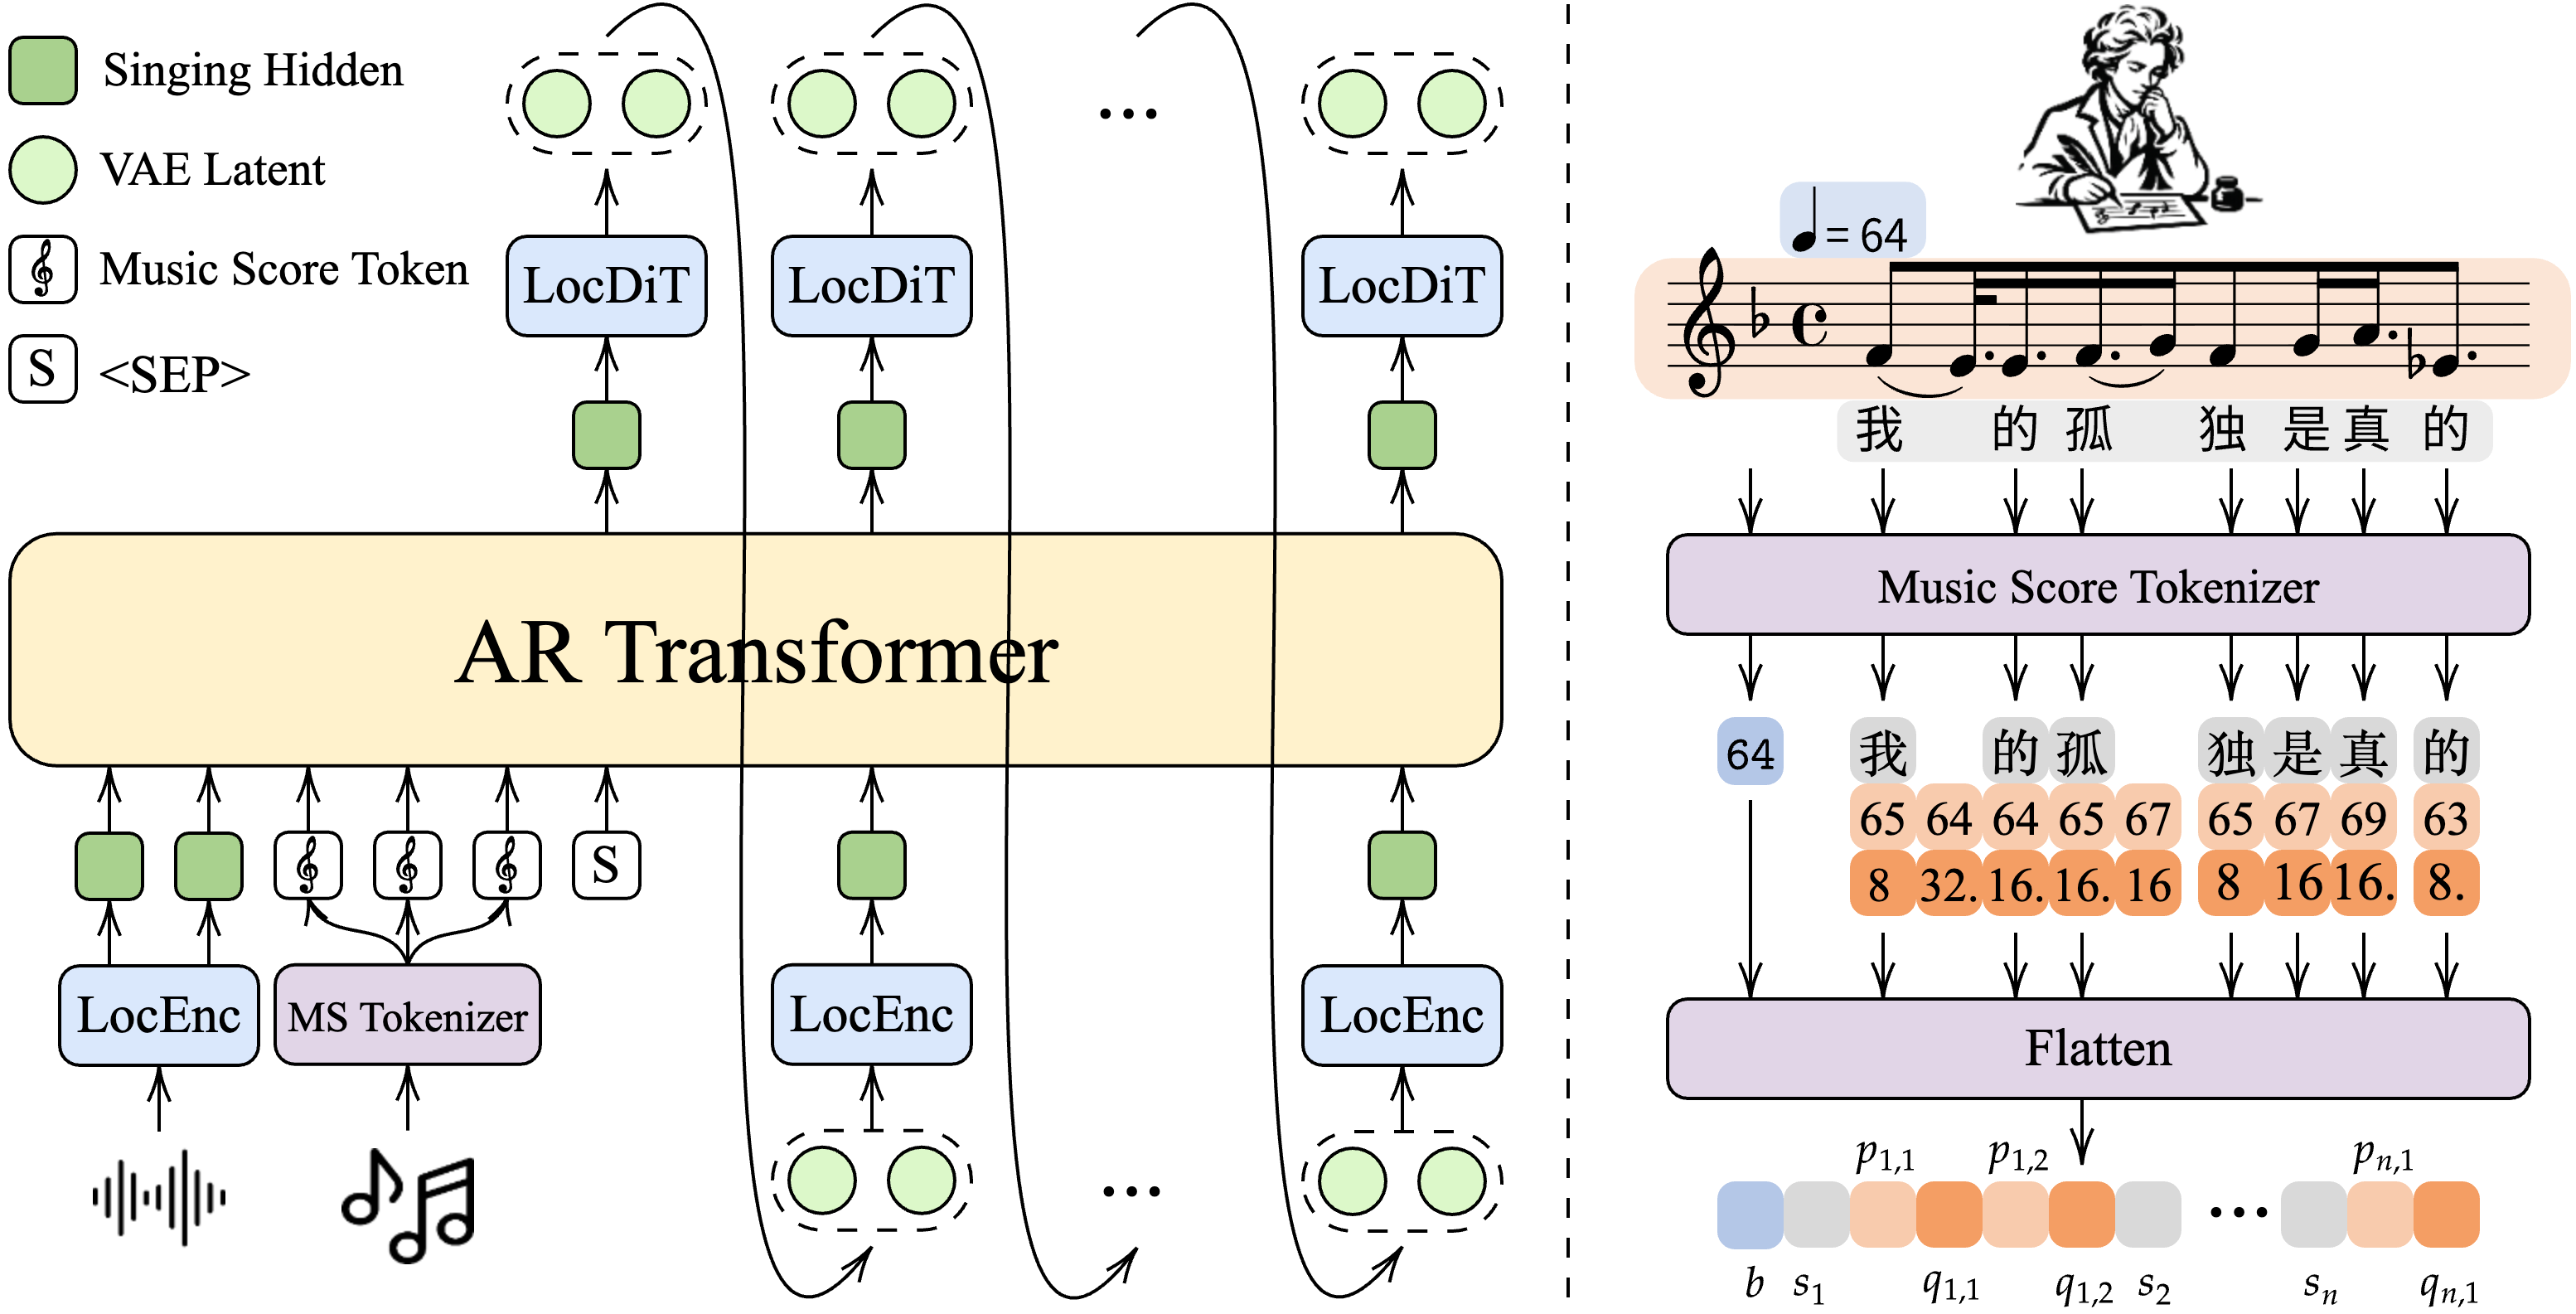
VocalRender는 음절 뒤에 해당 음절이 담당할 음높이와 음가 토큰을 차례로 끼워 넣는 인터리브 표현을 사용합니다. 한 음절에 음표가 여러 개 붙어도 입력 순서 자체가 대응 관계를 보존합니다. 연구진은 이 방식이 음소 단위 정렬이나 초 단위 길이 라벨 없이도 실제 악보 구조를 표현하도록 설계됐다고 설명합니다.
이미지 출처: VocalRender 논문 Figure 2, arXiv
AR Transformer와 확산 모델을 묶은 구조
핵심 생성기는 autoregressive diffusion model, 즉 ARDM입니다. AR Transformer가 지금까지 생성한 음향 문맥과 악보 토큰을 읽고 다음 구간의 조건을 만들면, LocDiT가 연속 음향 잠재 공간의 다음 패치를 생성합니다. 동시에 정지 여부를 예측해 전체 출력 길이도 생성 과정에서 결정합니다. 미리 고정된 음향 캔버스를 만드는 대신 노래를 구간별로 이어 가는 구조입니다.
음향 표현에는 이산 토큰 대신 오디오 VAE의 연속 잠재값을 사용합니다. 논문은 이 선택이 음높이, 음색, 발음처럼 가창에서 중요한 세부 정보를 양자화 과정에서 잃는 문제를 줄이기 위한 것이라고 밝힙니다. 기반 구조는 VoxCPM2에서 초기화했으며, 짧은 참조 음성을 넣어 음색을 조건으로 사용할 수도 있습니다.
2300시간 학습과 공개된 평가 결과
공개 모델 VocalRender는 여러 공개 데이터셋을 정제해 만든 CrawlSinger-OS 약 2300시간으로 학습됐습니다. 연구진의 Opencpop 평가에서 VocalRender-Pro는 단어 오류율 3.88%, 화자 유사도 0.929를 기록했습니다. 다만 Pro는 내부 데이터까지 활용한 별도 설정이고, 기본 공개 모델과 구분해서 읽어야 합니다. 기본 VocalRender의 같은 평가 수치는 WER 4.44%, 유사도 0.922입니다.
주관 평가에서도 기본 VocalRender는 비교 기준으로 삼은 경쟁 모델 SoulX-Singer보다 자연스러움 CMOS가 0.42점 높았습니다. 이 결과는 연구진이 구성한 데이터와 평가 조건에서 나온 수치이므로, 모든 언어와 장르에서 우위라는 뜻은 아닙니다. 현재 논문이 강조하는 최고 성능 범위도 중국어 가창입니다.
작곡 워크플로에서 달라지는 점
실무적으로 흥미로운 부분은 생성 모델이 작곡 데이터 구조에 가까워졌다는 점입니다. MIDI나 악보 편집기에서 이미 정해 둔 음높이·음가·BPM을 다시 F0 곡선이나 프레임 길이로 변환하는 단계를 줄일 수 있습니다. 멜리스마를 입력 구조에서 직접 표현하므로, 보컬 데모 제작이나 가이드 보컬 렌더링 같은 작업과도 연결하기 쉽습니다.
- 작곡가는 음표 단위 의도를 유지하면서 가창을 빠르게 시안화할 수 있습니다.
- 개발자는 MIDI 파서와 가사 정렬기를 앞단에 두는 비교적 명확한 파이프라인을 설계할 수 있습니다.
- 참조 음색 사용 시에는 당사자 동의와 음성 권리, 결과물 고지 정책을 함께 마련해야 합니다.
Threads의 한국어 AI 커뮤니티에서도 가사와 MIDI만으로 48kHz 가창을 만든다는 점이 주목받았습니다. 다만 소셜 게시물은 화제성 파악에만 참고했고, 구조와 수치 확인은 논문과 공식 코드 저장소를 기준으로 했습니다.
아직 확인해야 할 한계
첫째, 논문 결과는 중국어 중심이며 한국어 발음과 받침, 음절 분해에서 같은 성능이 나오는지는 별도 검증이 필요합니다. 둘째, 공개 모델과 Pro 모델의 학습 데이터가 다르므로 표의 최고 수치를 그대로 공개 체크포인트 성능으로 받아들이면 안 됩니다. 셋째, 자연스러운 결과와 별개로 보컬 음색의 권리와 데이터 라이선스는 실제 서비스 도입 전에 반드시 점검해야 합니다.
VocalRender의 의미는 노래를 생성했다는 사실보다, 작곡가가 이미 사용하는 기호적 악보를 생성 모델의 기본 언어로 삼았다는 데 있습니다. 코드와 데모가 공개된 만큼 다음 관전 포인트는 다국어 확장, DAW 연동, 그리고 공개 체크포인트의 실제 재현성입니다.
참고 자료
'ML & DL' 카테고리의 다른 글
| Dyna-2 로봇 스케일링 법칙 — 인간 영상 100만 시간의 의미 (1) | 2026.08.11 |
|---|---|
| NVIDIA RAPIDS가 CUDA-X로 바뀐다 — 26.08 전환 체크리스트 (0) | 2026.08.11 |
| Wan-Animate-2 공개 — 구동 영상을 직접 읽는 캐릭터 애니메이션 AI (0) | 2026.08.10 |
| Hunyuan3D-Buffalo 1.0 — 생성과 편집을 하나로 묶은 3D AI (0) | 2026.08.10 |
| #2 신경망의 기본 구조와 활성화 함수, 역전파 알고리즘 (2) | 2025.03.18 |


