Step 5 Preview 성능·기능·오픈웨이트 공개 일정 정리
Step 5 Preview는 2026년 9월 22일 기준 StepFun 제품과 API에서 사용할 수 있으며, 오픈웨이트 공개는 10월 15일로 예고돼 있습니다. 코딩 성능은 평가별로 차이가 커서 ‘최상위 모델을 전면 대체한다’고 단정할 수 없습니다.
기준 자료는 StepFun의 Step 5 Preview: Advancing the Pareto Frontier 발표와 개발자 모델 문서, 현재 요금표입니다. 아래 성능 수치는 별도 표시가 없는 한 발표사가 공개한 평가 결과이며, 이 글에서 API 실험으로 재현한 값은 아닙니다.
- 제품 접근과 가중치 공개 일정의 차이
- MoE 구조·긴 문맥·입출력 지원 범위
- 코딩 벤치마크의 실행 조건과 점수 읽는 법
- 모델과 에이전트 실행 앱의 역할
- 도입 전 품질·비용·라이선스 확인 항목
발표 페이지의 ‘open-weight 모델 비교’라는 표현을 현재 가중치 다운로드가 가능하다는 뜻으로 읽으면 안 됩니다. API 이용 가능 여부와 가중치 배포 상태는 서로 다른 확인 항목입니다.
원문: StepFun 공식 Step 5 Preview 발표
1. Step 5 Preview 공개 일정: 지금 쓸 수 있는 범위
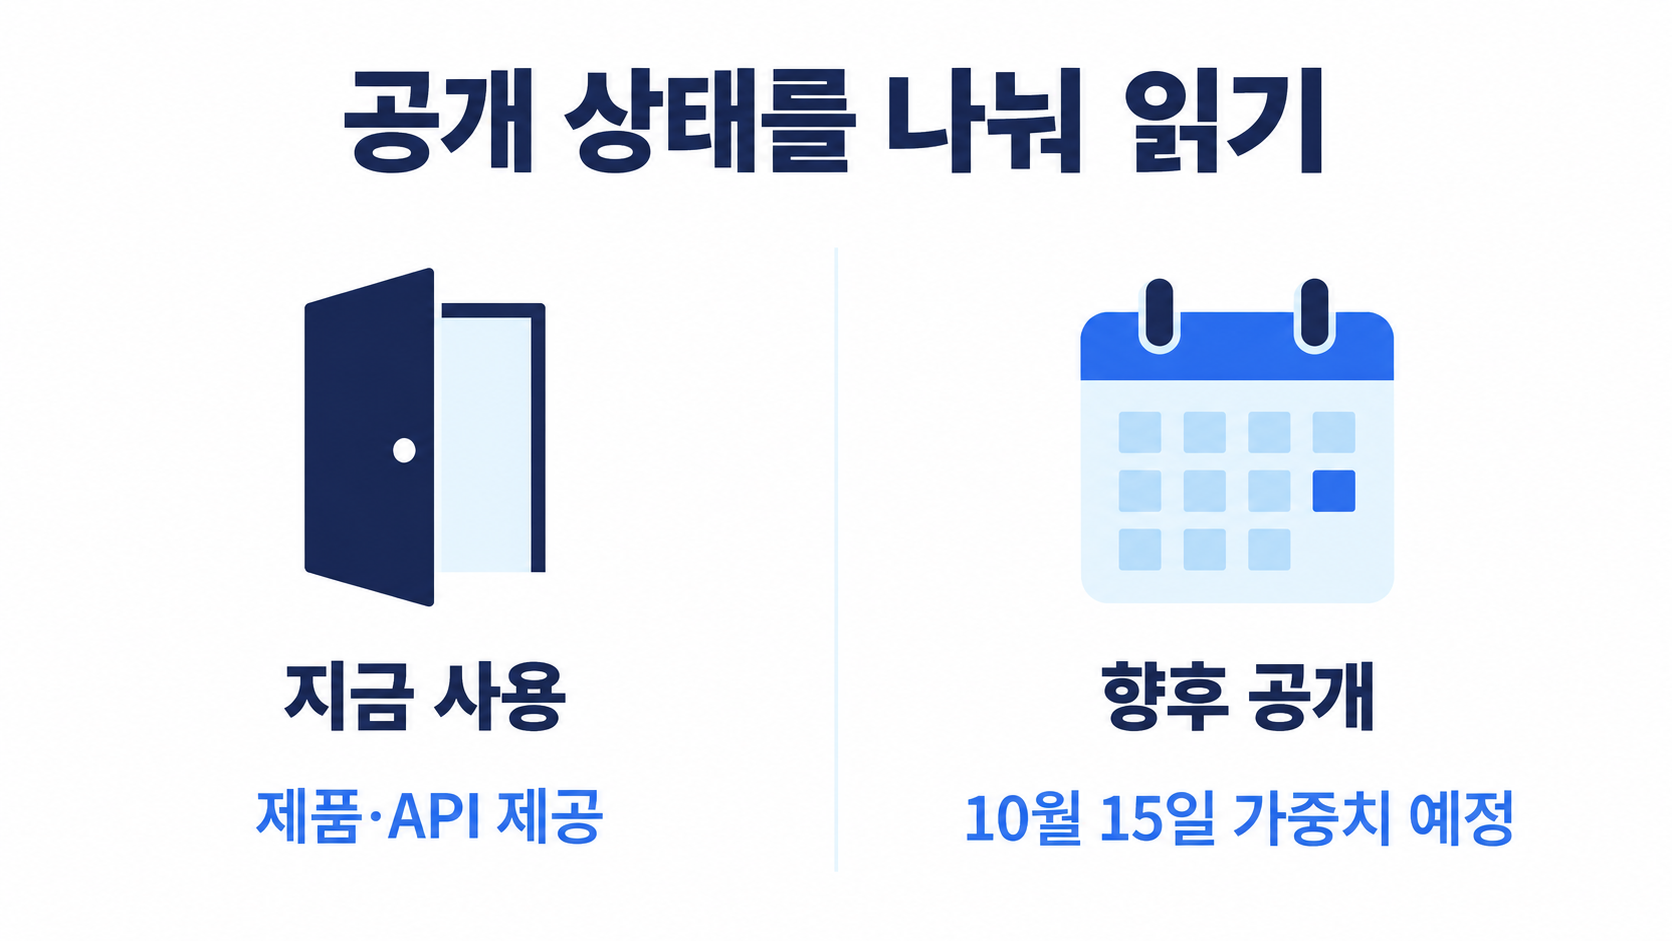
제품·API 접근과 가중치 배포
공식 발표는 제품과 API를 통한 이용을 안내하고, 가중치 배포 날짜를 별도로 제시합니다. 영문 발표의 표현은 ‘open weights’입니다. 배포 때 공개될 라이선스·모델 카드·파일을 확인하기 전에는 상업적 재배포나 수정 모델 배포 권한까지 확정하지 않습니다.
확인 기준일을 붙이는 이유
공식 페이지에는 ‘오늘’이라는 표현이 있으므로 이 글은 정확한 출시 시각을 추정하지 않습니다. 현재 상태와 예정일을 나누어 기록하고, 일정이 바뀌면 원문의 마지막 이용 안내를 우선 확인합니다.
2. Step 5 Preview 기능: 600B·27B·1M은 무엇인가
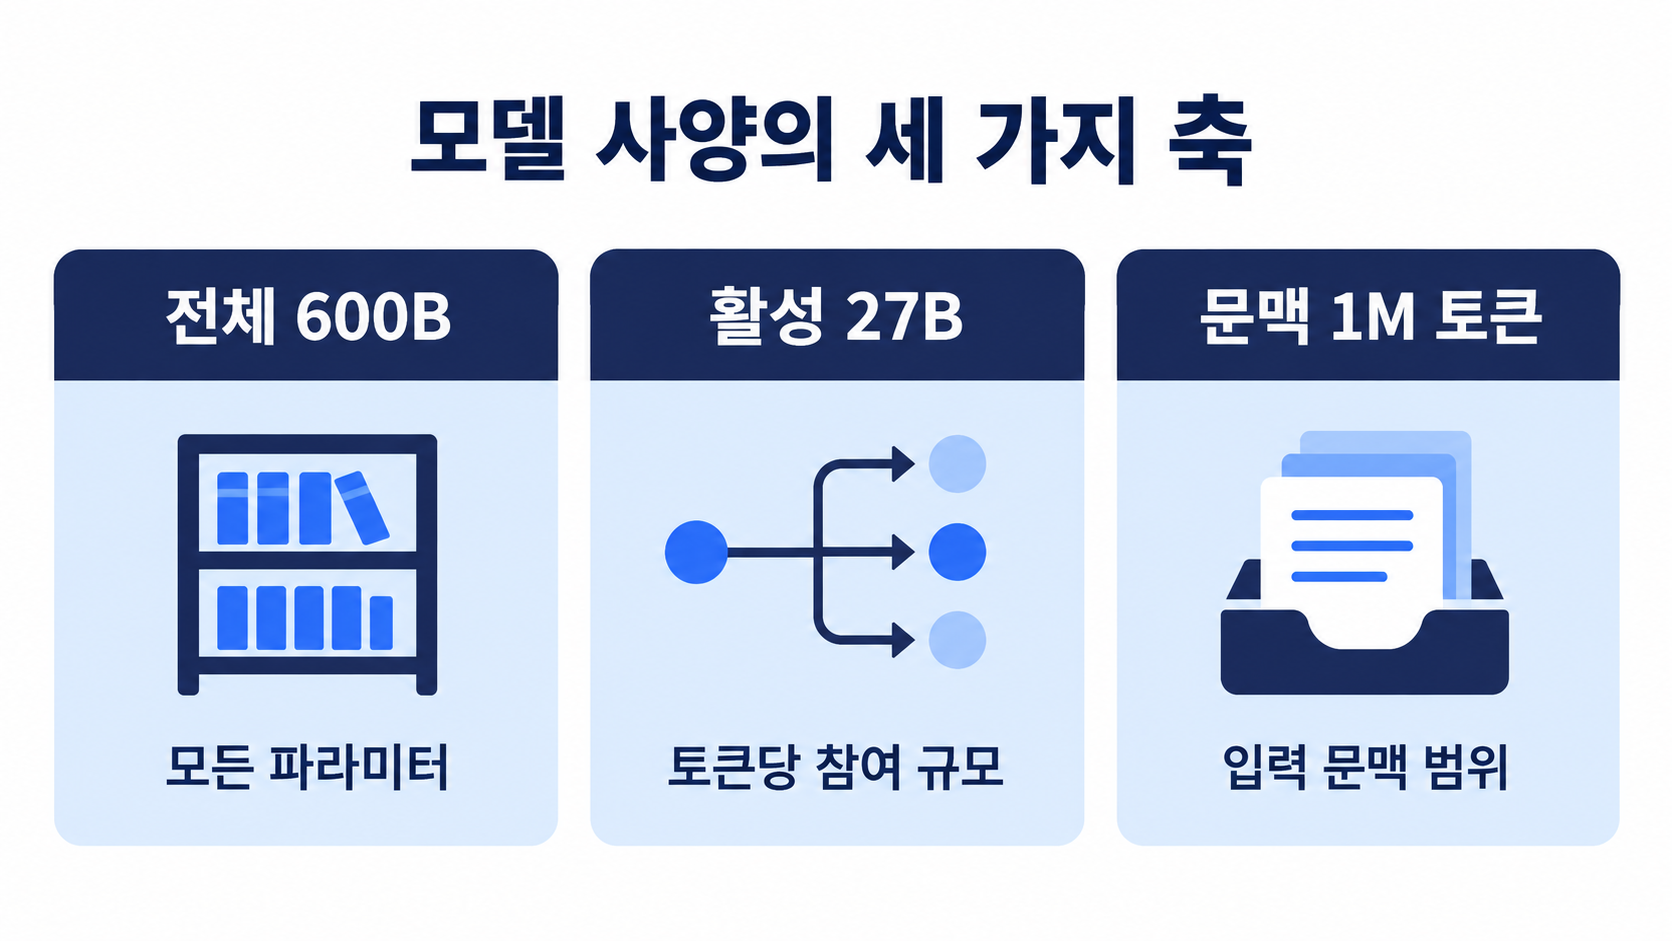
전체 크기와 토큰당 활성 규모
StepFun은 희소 Mixture-of-Experts(MoE) 구조를 사용하며 전체 파라미터가 600B, 토큰당 활성 파라미터가 27B라고 설명합니다. 두 값은 각각 모델 전체 규모와 한 토큰을 처리할 때 참여하는 규모를 가리킵니다.
긴 문맥과 멀티모달 입력
공식 모델 문서에 따르면 모델 ID는 step-5-preview, 문맥 창은 1M 토큰, 최대 출력은 64k 토큰입니다. 입력은 텍스트·이미지·동영상이고 출력은 텍스트입니다. 영상 입력을 지원한다는 말은 영상 파일을 생성한다는 뜻이 아닙니다.
지원 기능에는 도구 호출, JSON Mode·JSON Schema, 스트리밍, 프롬프트 캐싱이 포함됩니다. 추론 강도는 low·medium·high로 나뉘며, 문서는 Chat Completions의 reasoning_effort와 Messages API의 output_config.effort를 구분합니다.
1M은 수용 가능한 문맥 범위에 관한 사양이지, 그 안의 모든 사실을 빠짐없이 활용한다는 보증은 아닙니다.
3. Step 5 Preview 성능표: 코딩 1위로 읽어도 될까
같은 발표 안에서도 순위가 달라집니다
아래는 현재 공식 발표의 코딩 평가에서 가져온 일부 결과입니다. Step 5 Preview는 High, 비교 모델은 Max 설정으로 표시돼 있습니다. 이는 같은 이름의 추론 설정을 맞춘 비교도 아니고, 실제 개발팀의 성공률을 직접 측정한 표도 아닙니다.
| 공식 발표의 평가 | Step 5 Preview | GPT-6 Astra | Claude Opus 5 |
|---|---|---|---|
| DeepSWE v1.1 | 67.7% | 74.1% | 74.0% |
| StepCodeBench | 49.0% | 61.0% | 63.9% |
| Terminal-Bench v4 | 33.3% | 57.9% | 52.3% |
StepCodeBench는 StepFun이 만든 내부 평가입니다. 553개 독립 저장소, 9개 작업 유형, 20개 응용 분야, 33개 언어를 포괄한다고 설명합니다.
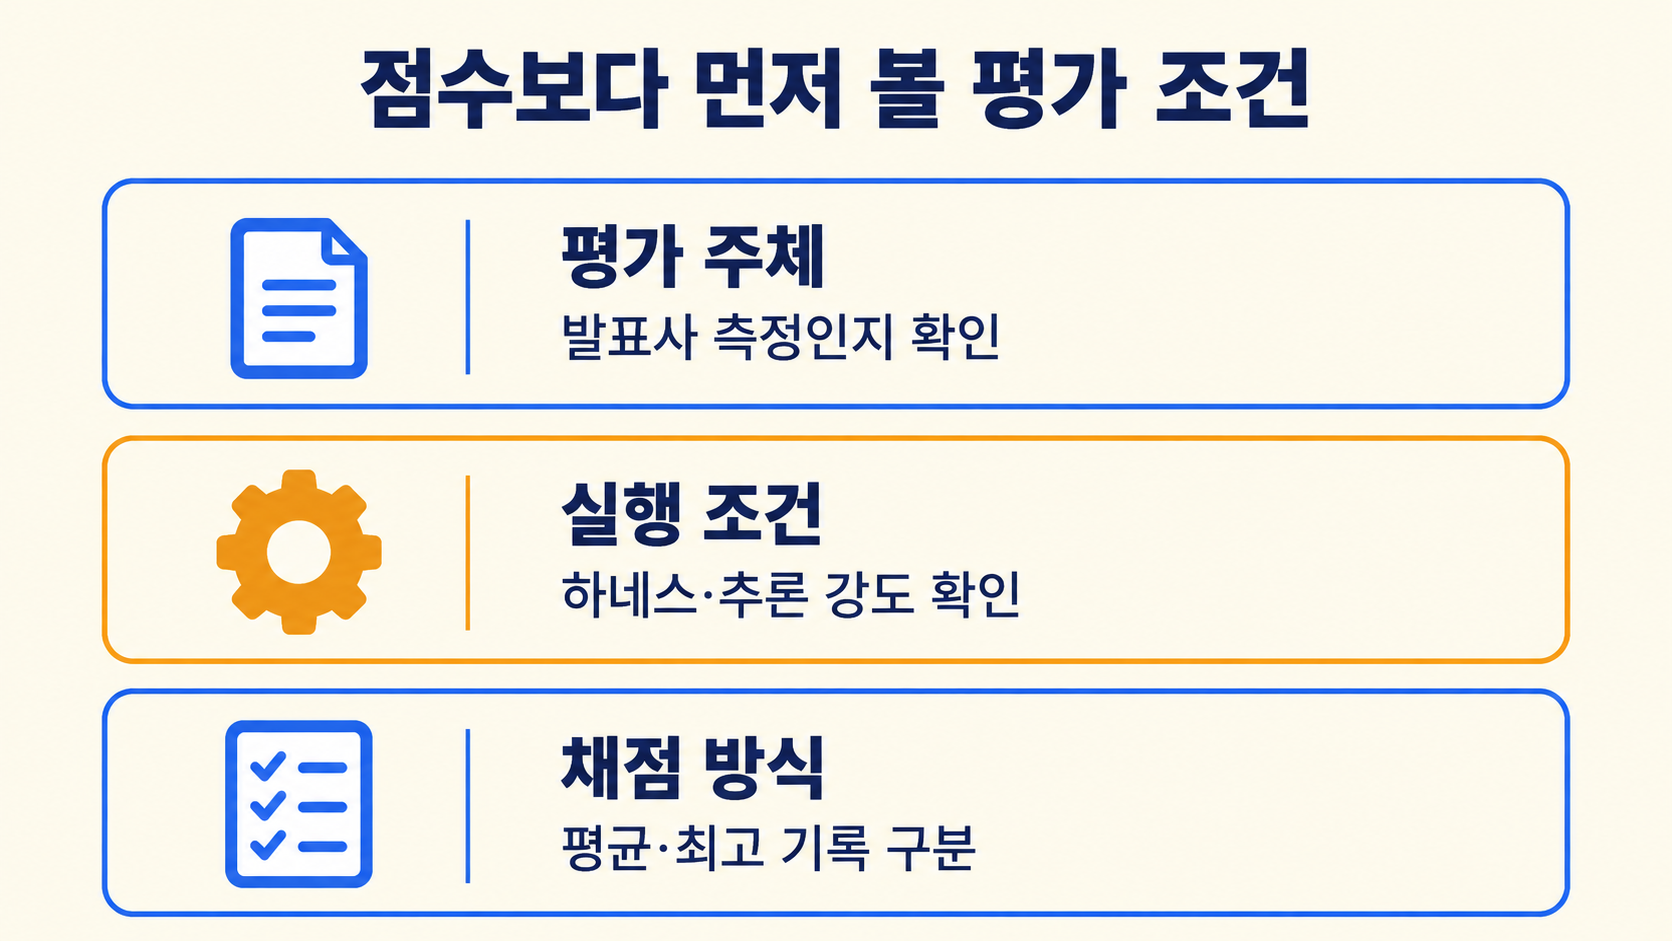
평가 주체·하네스·집계 방식이 중요합니다
DeepSWE v1.1에는 SWE-agent 하네스와 temperature=1.0, top_p=0.95가 명시돼 있습니다. StepCodeBench의 49.0%는 발표에서 avg@4로 표기합니다. 따라서 ‘한 번 실행하면 우리 작업 절반을 해결한다’는 식으로 바꿔 말하지 않습니다.
발표 각주에 따르면 도구 사용 HLE에서는 일부 모델이 텍스트 전용 부분집합, 나머지가 전체 데이터셋을 사용했습니다. 이 조건이 다른 결과를 그대로 줄 세워 비교하지 말라는 주의도 원문에 있습니다.
4. 에이전트 기능은 어떤 실행 앱과 연결해야 하나
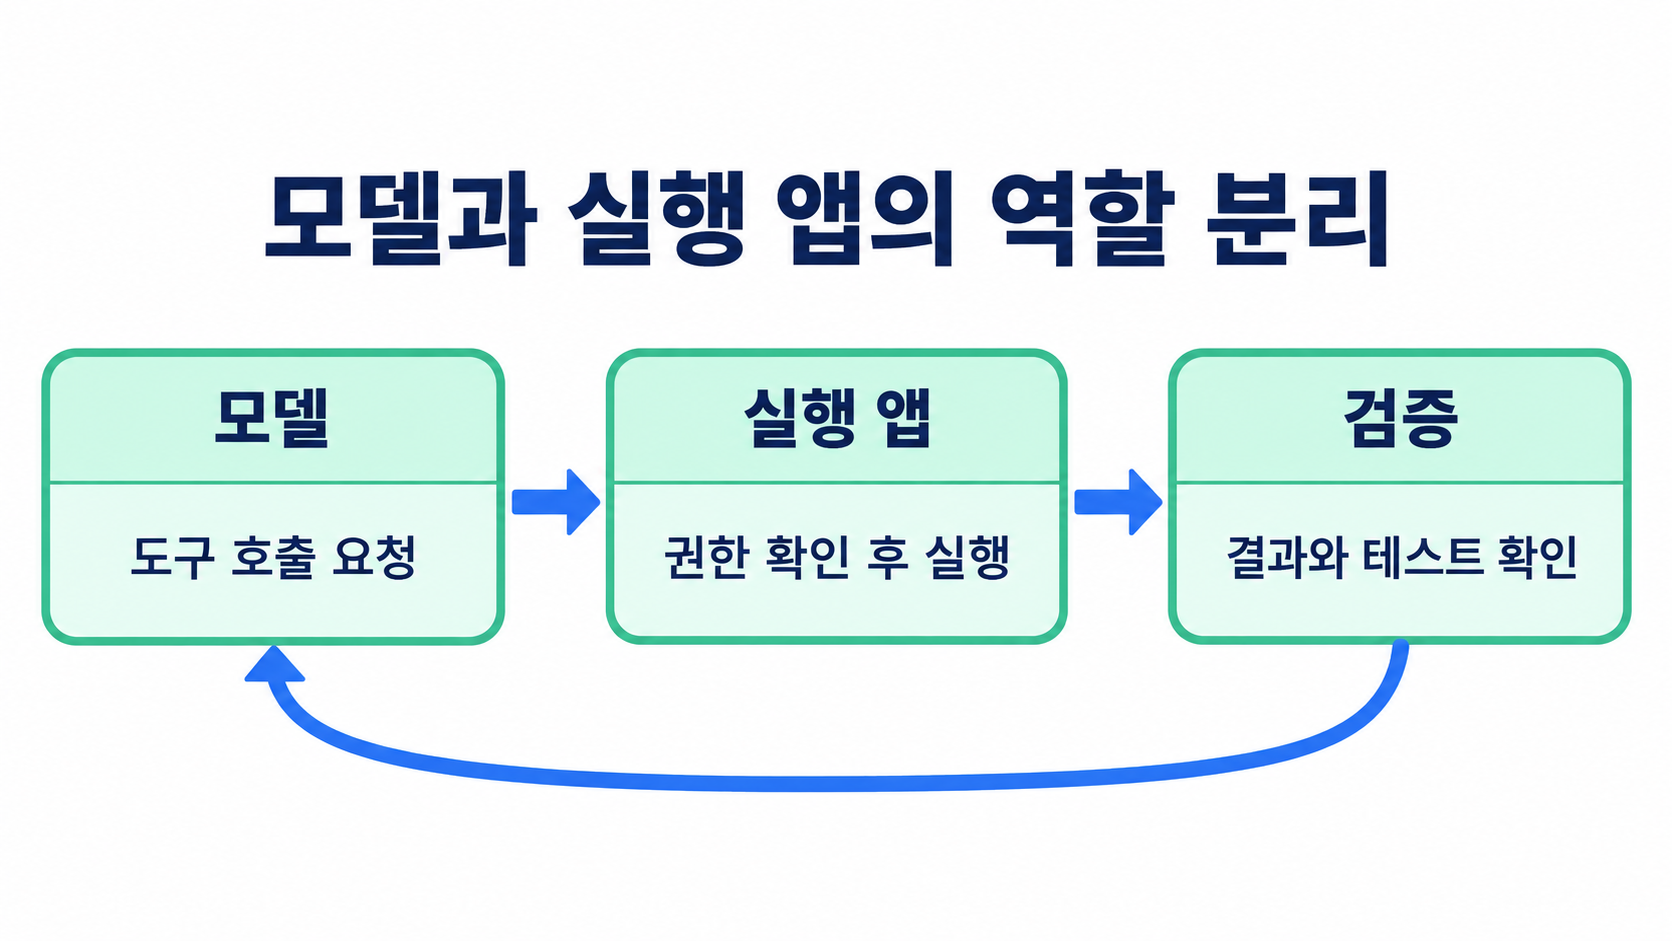
모델이 제안하고 앱이 실행합니다
개발자 문서는 도구·검색·코드 실행 기능을 모델을 통합한 애플리케이션이 제공한다고 명시합니다. 모델 스스로 로컬 환경이나 외부 서비스에 접근하는 것은 아닙니다.
예를 들어 오류 로그를 읽고 수정을 요청하는 코딩 앱이라면, 모델의 도구 호출을 받은 앱이 대상 저장소와 허용 명령을 확인하고 실행 결과를 돌려줍니다. 도해의 권한 확인 단계는 이런 운영 설계 권고이며 StepFun이 제공하는 특정 승인 UI를 재현한 것이 아닙니다.
시연 결과를 내 프로젝트에 적용하는 방법
적용 실험에서는 기존 모델과 새 모델에 같은 작업 설명·권한·실행 예산을 주고 변경 파일과 테스트 로그를 함께 남기는 방식을 권합니다. 완료 기준을 설계하는 방법은 AI 코딩 에이전트 검증 루프: 테스트 통과와 완료의 차이에서 더 자세히 다뤘습니다.
5. 도입 전 확인할 품질·비용·가중치 공개 조건
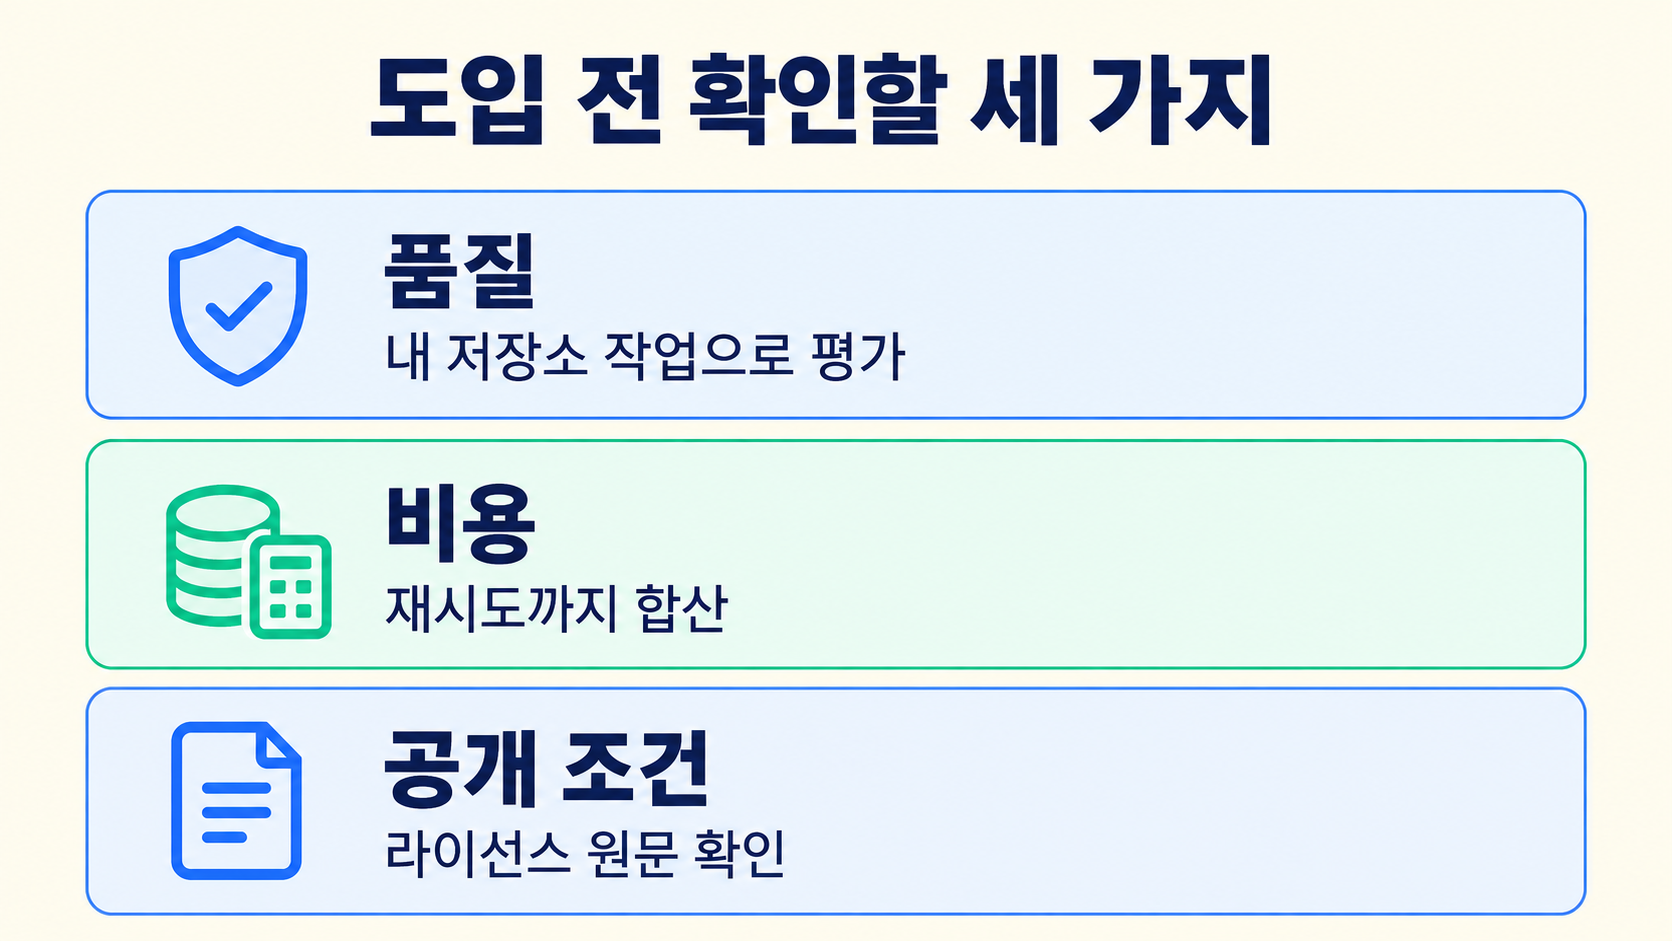
샘플 작업은 실패 유형이 드러나게 고릅니다
간단한 신규 코드 생성만 비교하기보다 기존 테스트를 고치는 작업, 여러 파일에 걸친 기능 수정, 불완전한 요구사항을 다시 묻는 작업을 나누어 평가하는 편이 좋습니다. 합격 기준을 먼저 정해 두면 말끔한 설명이 실제 변경 품질을 가리는 일을 줄일 수 있습니다.
가중치 공개 이후에는 배포 파일 유무 외에도 라이선스, 상업 이용 조건, 모델 카드, 지원 실행 환경을 따로 확인해야 합니다. 지금은 가중치가 배포된 상태를 전제로 로컬 설치 절차를 안내할 단계가 아닙니다.
단가 외에 재시도와 추론 출력도 셉니다
현재 공식 요금표의 1M 토큰당 가격은 캐시 미적중 입력 $1.00, 캐시 적중 입력 $0.05, 출력 $2.70입니다. 출력 과금에는 추론 과정과 최종 답변이 함께 포함됩니다. 캐시 미적중 입력 가격에는 새 내용을 캐시에 쓰는 비용이 포함된다는 각주도 확인했습니다.
실무 비교에서는 실패한 호출과 재시도까지 포함한 총비용을 기록해야 합니다. 중간에 다시 실행한 작업이 실제 부작용을 중복시키는 문제는 AI 에이전트 재시도 중복 실행 방지: 멱등성 설계와 함께 점검할 수 있습니다.
6. Q&A와 정리
Q1. 이미지 생성 모델로도 쓸 수 있나요?
현재 모델 문서의 출력 유형은 텍스트입니다. 그림이나 영상을 입력해 해석하는 기능과 이미지 파일을 생성하는 기능을 혼동하지 않아야 합니다.
Q2. 이미지 파일은 어떤 형식을 받나요?
공식 문서는 JPG/JPEG, PNG, WebP, 정적 GIF를 지원한다고 안내합니다. 한 요청에서 최대 60장까지이며, 이미지 해상도에 따른 입력 처리 조건도 함께 확인해야 합니다.
Q3. 긴 동영상 URL을 그대로 넣어도 되나요?
모델 문서는 개별 MP4 URL 파일에 128MB 미만 제한을 안내하고 5분 미만 길이를 권장합니다. 문맥 창이 길다는 사양만으로 파일 전송 제한까지 없어지는 것은 아닙니다.
Q4. 한국어 코드 리뷰도 충분히 잘하나요?
이번에 확인한 자료만으로 한국어 요구사항·한국어 주석이 섞인 저장소의 품질을 별도 수치로 확정할 수 없습니다. 그런 프로젝트라면 영문 벤치마크 대신 해당 저장소의 실제 이슈를 평가에 포함하는 편이 정확합니다.
Q5. 공개일에 이름과 API 동작이 그대로 유지되나요?
현재 이용하는 Preview ID와 향후 배포 모델의 호환성이 영구적으로 유지된다고 가정하지 않습니다. 전환 시점에 모델 ID, 변경 기록, 입력 매개변수를 확인하고 기존 평가를 다시 실행해야 합니다.
모델을 시험할 때는 대표적인 실패 사례와 합격 기준부터 정해 두십시오.
7. 참고 자료
'AI 트렌드' 카테고리의 다른 글
| Claude 연구 자동화 26%, 완전 자율 연구라는 뜻일까? (0) | 2026.09.20 |
|---|---|
| OpenAI 에이전트 무단 업로드, 인용·파일 공유에서 생긴 일 (0) | 2026.09.18 |
| GPT-Live-1 API 가격·기능, 음성 에이전트 도입 조건 (0) | 2026.09.17 |
| Fugu Max·Ultra v2 출시, 가격·성능·선택 조건 정리 (0) | 2026.09.12 |
| OpenAI 자동 연구 인턴, 3.1 작업일은 생산성 몇 배일까? (0) | 2026.09.08 |


