Hunyuan3D-Buffalo 1.0 — 생성과 편집을 하나로 묶은 3D AI

텍스트나 이미지로 3D 메시를 만드는 모델은 빠르게 늘었지만, 실제 제작에서는 결과물을 만든 뒤 구조를 이해하고 부품을 나누고 특정 부분만 고치는 과정이 더 오래 걸립니다. 텐센트 혼위안 연구진이 공개한 Hunyuan3D-Buffalo 1.0은 이 단절을 줄이기 위해 3D 이해, 텍스트 기반 생성, 자연어 편집, 부품 단위 생성을 하나의 멀티모달 프레임워크에 통합한 연구입니다.
이 글에서는 논문과 공식 프로젝트 페이지를 기준으로 모델의 핵심 구조와 데이터 구성, 그리고 3D 콘텐츠 제작 현장에서 무엇이 달라질 수 있는지 정리합니다. Threads의 한국어 AI 커뮤니티에서도 ‘한 번 생성하고 끝나는 메시보다 계속 수정 가능한 자산’이라는 점이 주목받고 있지만, 성능 수치와 구조 설명은 공식 자료만을 기준으로 확인했습니다.
무엇을 하나의 모델로 묶었나
Hunyuan3D-Buffalo 1.0이 다루는 작업은 네 가지입니다. 3D 객체에 관한 질의응답과 공간·구조 이해, 텍스트에서 3D 객체를 만드는 생성, 자연어 지시에 따른 3D 편집, 그리고 의미가 있는 부품을 골라 생성하는 작업입니다. 기존 파이프라인에서는 각 단계가 서로 다른 모델과 표현을 사용하기 쉬웠지만, 이 연구는 공통된 3D 멀티모달 표현을 중심에 둡니다.
- 3D 이해: 객체의 의미, 구조, 공간 관계를 질의응답과 그라운딩 형태로 처리합니다.
- 텍스트-3D 생성: 자연어 조건에서 고품질 3D 자산을 합성합니다.
- 지시 기반 편집: 원본 객체의 표현을 조건으로 사용해 수정하지 않은 부분을 보존하려 합니다.
- 부품 생성: 언어로 지정한 의미 단위의 부품을 분리하거나 새로 생성합니다.
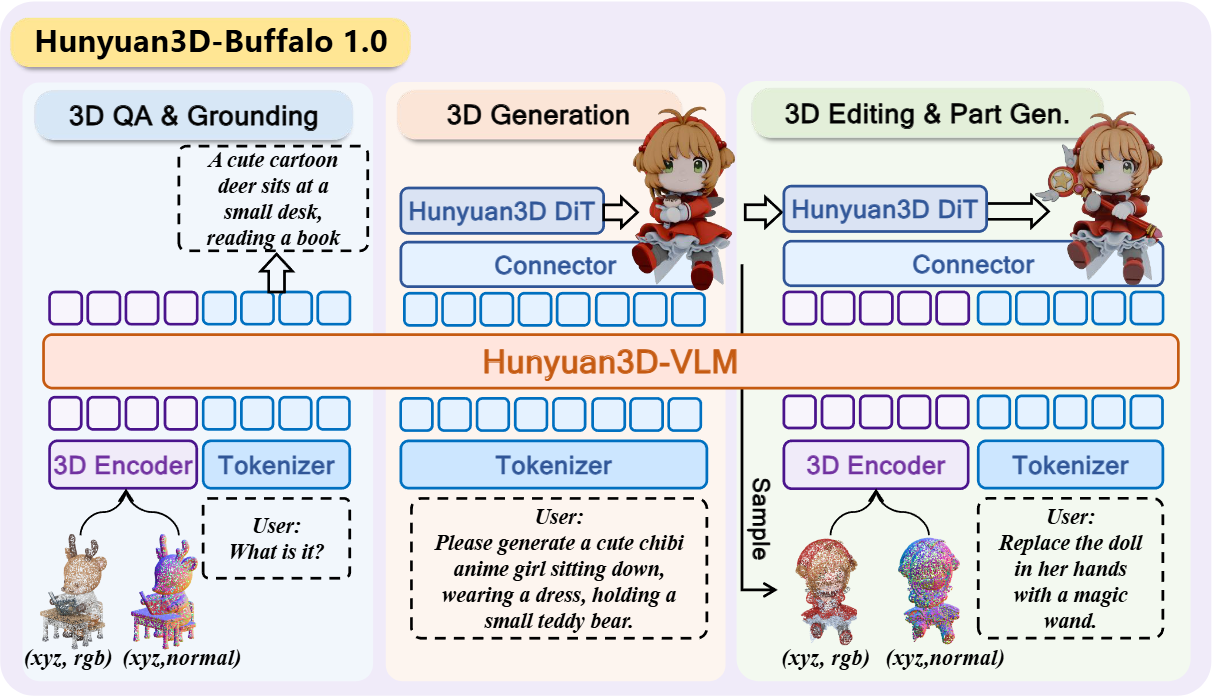
이미지 출처: Tencent Hunyuan 공식 프로젝트 페이지
Hunyuan3D-VLM과 DiT의 역할 분담
공식 설명에 따르면 프레임워크의 중심에는 Hunyuan3D-VLM이 있습니다. 이 모듈은 3D 질의응답, 그라운딩, 생성, 편집, 부품 분해를 잇는 의미 표현을 담당합니다. 이어 Hunyuan3D DiT가 이 조건을 받아 실제 3D 합성을 수행합니다. 편집과 부품 생성에서는 원본 객체 표현도 함께 조건으로 넣어 전체 구조와 수정 대상이 아닌 영역을 유지하도록 설계했습니다.
이 구분은 실무적으로 중요합니다. ‘의자가 무엇인지 이해하는 단계’와 ‘팔걸이만 바꾸는 기하 생성 단계’를 완전히 분리하지 않고, 이해 결과가 생성 조건으로 이어지기 때문입니다. 논문은 생성 능력과 이해 능력이 편집 성능에도 도움을 준다는 분석을 제시합니다. 즉 여러 작업을 단순히 한 제품에 모아둔 것이 아니라, 공통 학습이 서로의 성능에 영향을 주도록 설계한 셈입니다.
8,700만 샘플은 어떻게 구성됐나
논문이 밝힌 학습 코퍼스는 총 8,700만 규모의 3D 멀티모달 샘플입니다. 구성은 이해용 2,500만 건, 텍스트-3D 쌍 5,000만 건, 편집 쌍 1,200만 건입니다. 특히 3D 편집 데이터가 부족하다는 문제를 해결하기 위해 Nano3D-v2를 활용해 대규모 편집 쌍을 구성했다고 설명합니다.
이 수치는 서로 다른 원천 객체가 8,700만 개라는 뜻으로 읽어서는 안 됩니다. 논문 표현은 여러 작업에 쓰는 ‘샘플’ 규모이며, 이해·생성·편집 학습 예시를 합산한 값입니다. 데이터의 세부 라이선스와 실제 배포 범위, 상업적 사용 조건은 모델·코드 공개물의 라이선스를 별도로 확인해야 합니다.
기존 텍스트-3D 도구와 다른 지점
기존 생성형 3D 도구는 처음부터 새 자산을 만드는 데 강점을 두는 경우가 많습니다. 그러나 게임, 제품 시각화, 디지털 트윈 작업에서는 생성 결과를 그대로 쓰기보다 형태를 반복적으로 고치고 특정 부품을 교체해야 합니다. Buffalo 1.0의 방향은 ‘생성 결과’보다 ‘수정 가능한 작업 상태’에 가깝습니다.
예를 들어 전체 의자 메시를 다시 만들지 않고 등받이 형태만 바꾸거나, 캐릭터가 든 소품만 교체하면서 나머지 기하를 유지하는 방식이 목표입니다. 자연어 지시와 3D 그라운딩이 안정적으로 연결된다면 아티스트의 반복 작업을 줄이고, 에이전트가 3D 툴을 조작하는 워크플로에도 활용될 수 있습니다. 다만 논문 데모 수준의 성공이 복잡한 상용 자산의 토폴로지, UV, 텍스처, 리깅, 애니메이션 품질까지 자동으로 보장한다는 의미는 아닙니다.
실무에서 확인해야 할 체크포인트
- 편집 보존성: 선택 영역을 고칠 때 주변 메시와 의미 없는 영역이 실제로 얼마나 유지되는지 확인해야 합니다.
- 후처리 비용: 생성된 기하의 토폴로지 정리, UV와 텍스처, 리깅에 필요한 시간을 함께 측정해야 합니다.
- 재현성과 공개 범위: 현재 공식 GitHub 저장소는 프로젝트 페이지를 가리키는 간단한 안내가 중심입니다. 가중치·추론 코드·실행 환경이 실제로 어느 범위까지 공개됐는지 최신 저장소 상태를 확인하는 편이 안전합니다.
- 데이터와 라이선스: 서비스나 상업 프로젝트에 적용하기 전 모델 라이선스와 입력·출력 자산의 권리를 별도로 검토해야 합니다.
따라서 지금 당장 기존 DCC 도구를 대체한다고 보기보다는, 3D 생성 모델이 ‘한 번 만드는 도구’에서 ‘이해하고 계속 고치는 도구’로 이동하는 신호로 보는 편이 정확합니다. 실제 도입 판단은 공개 코드와 가중치, 복잡한 메시에서의 편집 일관성, 기존 Blender·Maya 파이프라인과의 연동성을 확인한 뒤 내려야 합니다.
마무리
Hunyuan3D-Buffalo 1.0의 핵심은 더 그럴듯한 단일 3D 결과보다 생성·이해·편집·부품 생성을 공통 표현으로 연결했다는 데 있습니다. 8,700만 규모의 멀티모달 학습 코퍼스와 VLM-DiT 결합은 편집 가능한 3D AI로 가는 구체적인 설계안을 보여줍니다. 앞으로 중요한 비교 기준도 첫 생성 품질만이 아니라 수정하지 않은 영역의 보존, 연속 편집의 안정성, 후처리 비용으로 넓어질 가능성이 큽니다.
참고 자료
'ML & DL' 카테고리의 다른 글
| VocalRender 공개 — 악보를 바로 읽는 가창 합성 AI (0) | 2026.08.10 |
|---|---|
| Wan-Animate-2 공개 — 구동 영상을 직접 읽는 캐릭터 애니메이션 AI (0) | 2026.08.10 |
| #2 신경망의 기본 구조와 활성화 함수, 역전파 알고리즘 (2) | 2025.03.18 |
| #1 딥러닝에서 가중치란 무엇인가요? (0) | 2025.03.18 |
| #3 Cost Function과 Activation Function은 무엇인가요? (2) | 2025.03.18 |


